
你在一家做工業感測器的公司負責官網,網站上有產品頁、技術文章、可以下載的技術白皮書,另外還有一區只給經銷商看的報價資料。你看到新聞說 AI 公司會拿網站內容去訓練模型,就在網路上抄了一份 AI 爬蟲名單,把 GPTBot、ClaudeBot、OAI-SearchBot、PerplexityBot、Claude-SearchBot 全部寫進網站的 robots.txt,也就是放在網站根目錄、告訴爬蟲哪些路徑可以抓的那個純文字檔,而且一律設成 Disallow: /。
結果一個月後,你在 ChatGPT 問台灣有哪些工業感測器廠商,回答引用的來源裡已經看不到自家官網。而經銷商報價頁只靠 robots.txt 擋著、沒有設登入,只要有人把網址貼給 AI 工具,還是可能被讀到。問題出在你把下面三件不同的事,當成同一件事在處理:
- 不想被拿去訓練:要擋的是訓練用的爬蟲。
- 想被 AI 搜尋找到:搜尋用的爬蟲反而要留著。
- 不想被看到:這件事 robots.txt 根本做不到,要靠登入。
所以想擋的沒擋住,想留的反而關掉了。只需要處理 OpenAI 的話,可以直接看 OAI-SearchBot 與 GPTBot 怎麼分開設定;這篇則是把六家的爬蟲放在一起講。
先按用途分類,再看是哪一家的爬蟲
爬蟲(crawler)是自動去網站抓網頁的程式,每支爬蟲送出請求時都會報上自己的名字,這個名字叫 user-agent,而 robots.txt 就是靠它來分辨要對誰套用哪些規則。「AI 爬蟲」並不是哪一家定義的分類,而是好幾種用途混在一起的說法。Google 把一般搜尋用的 Googlebot,和管 Gemini 訓練的 Google-Extended 分開;OpenAI 也把 OAI-SearchBot、GPTBot 和 ChatGPT-User 分開;而 Anthropic、Perplexity 和 Apple,同樣各有好幾個名字。所以先決定你要管的是哪一種用途,再去找各家對應的名字,才不會像那家感測器公司一樣,想擋訓練卻順手關掉了搜尋。
| 目的 | 對應的名字 | 感測器公司的決定 | 要注意的地方 |
|---|---|---|---|
| 讓 AI 搜尋找到頁面 | OAI-SearchBot、Claude-SearchBot、PerplexityBot、Applebot;Google 的 AI 摘要(搜尋結果上方由 AI 整理的回答)沿用 Googlebot | 產品頁和技術文章全部開放 | 開放了只代表讀得到,會不會被引用還要看題目和內容 |
| 不讓內容拿去訓練模型 | GPTBot、ClaudeBot、Google-Extended、Applebot-Extended | 技術白皮書不給訓練用 | 擋訓練用的名字,不會連帶擋掉搜尋 |
| 使用者提問時即時讀網頁 | ChatGPT-User、Claude-User、Perplexity-User | 先不特別處理 | ChatGPT-User 和 Perplexity-User 不一定照 robots.txt 走 |
| 降低伺服器負擔 | robots.txt、網站防火牆(WAF,擋在網站前面、依規則過濾請求的服務)或 CDN(架在網站前面、幫忙快取和轉送網頁的服務) | 目前流量不大,先不處理 | 擋太多,公開內容也會變得不容易被找到 |
| 資料保密 | 登入、權限 | 經銷商報價改成登入後才看得到 | robots.txt 管不了誰能打開頁面 |
Google 在 robots.txt 的說明裡寫得很清楚,這個檔案主要是用來管理爬蟲的流量,避免網站被請求塞爆;如果想讓頁面不出現在 Google,要用 noindex(寫在頁面裡、要求搜尋引擎不要收錄的標記)或密碼保護。所以經銷商報價這類要保密的內容,先用登入擋起來,再來談 robots.txt 怎麼寫。
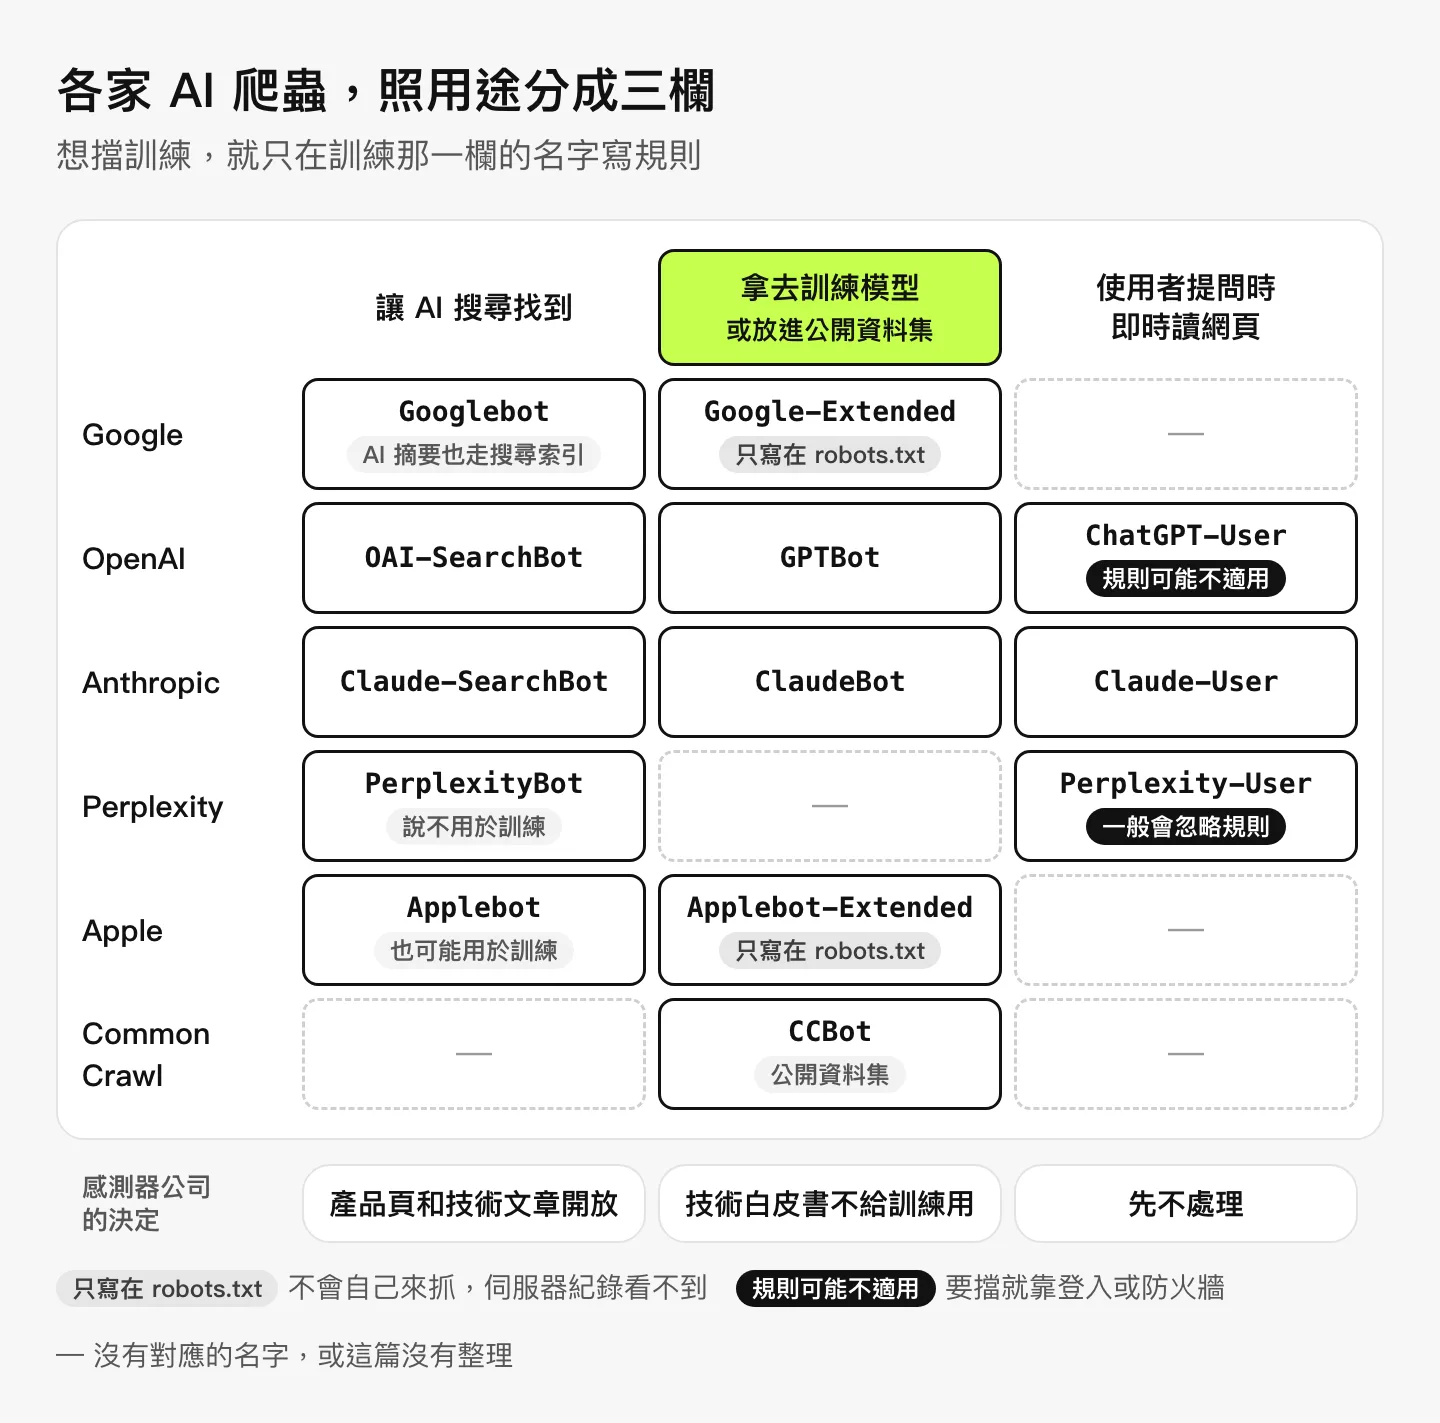 想擋訓練,只要替訓練用的那幾個名字寫規則;搜尋用的名字留著,頁面在 AI 搜尋才找得到。各家的細節在下一節的對照表。
各家 AI 爬蟲用途與設定對照表
下表把各家文件寫的用途和設定方式放在一起,最後面的「要注意的地方」,是各家特別提醒、也最容易被誤會的事。
| 平台/user-agent | 拿來做什麼 | robots.txt 怎麼設 | 要注意的地方 |
|---|---|---|---|
| Googlebot | Google 搜尋的抓取與索引,AI 摘要和 AI 模式也從搜尋索引裡挑頁面 | 用 User-agent: Googlebot 或 User-agent: * 那組規則管理 | AI 摘要沒有另外的爬蟲;要限制頁面內容出現在 AI 摘要,用 nosnippet(要求搜尋結果不要顯示這頁摘要的標記)這類設定 |
| Google-Extended | 管兩件事:Google 抓到的內容能不能拿去訓練 Gemini 模型;Gemini 應用程式回答時能不能拿來參考 | User-agent: Google-Extended 獨立一組 | 不會自己發出請求,伺服器紀錄裡看不到它;不影響 Google 搜尋的收錄和排名 |
| OAI-SearchBot | 讓網站出現在 ChatGPT 的搜尋功能 | 可以單獨允許或拒絕 | 拒絕後不會出現在 ChatGPT 搜尋的回答裡,但仍可能以導覽連結出現(只給網址、不引用內文) |
| GPTBot | 抓取可能用來訓練 OpenAI 基礎模型的內容 | 和 OAI-SearchBot 分開設定 | 擋它不影響 ChatGPT 搜尋 |
| ChatGPT-User | 使用者在 ChatGPT 或自訂 GPT 裡要求開某個網頁時才去讀 | OpenAI 說 robots.txt 規則可能不適用 | 要擋就靠登入或伺服器端的存取控制 |
| ClaudeBot | 收集可能拿來訓練 Claude 的網頁內容 | 用 User-agent: ClaudeBot 單獨一組 | Anthropic 把訓練、搜尋和使用者請求拆成三個名字 |
| Claude-SearchBot | 建立 Claude 搜尋用的索引,改善搜尋結果 | 可以單獨控制 | 擋掉後,Claude 的搜尋結果比較難出現你的頁面 |
| Claude-User | 使用者在 Claude 問問題、需要上網查時去讀網頁 | Anthropic 說三個名字都遵守 robots.txt | 擋掉後,使用者在 Claude 問問題時就讀不到你的頁面 |
| PerplexityBot | 讓網站出現在 Perplexity 的搜尋結果並附上連結 | 可以單獨允許或拒絕 | Perplexity 說它不拿來抓基礎模型的訓練資料 |
| Perplexity-User | 使用者在 Perplexity 提問時即時讀網頁 | Perplexity 說這類請求一般會忽略 robots.txt | 要擋就看網站防火牆的規則和登入 |
| Applebot | Spotlight、Siri、Safari 等搜尋功能,也可能拿來訓練 Apple 的基礎模型 | 支援一般的 robots 規則 | 擋掉它,Apple 的搜尋功能也一起抓不到你;只想擋訓練就改設 Applebot-Extended |
| Applebot-Extended | 決定 Applebot 抓到的內容,能不能拿去訓練 Apple 的生成式 AI 模型 | robots.txt 獨立一組,可以依路徑設定 | 不會自己抓網頁;擋了它,頁面仍可能出現在 Apple 的搜尋結果 |
| CCBot | Common Crawl 的爬蟲,抓下來的網頁會放進任何人都能下載的公開資料集 | User-agent: CCBot | 有人會冒用 CCBot 的名字,可以用 Common Crawl 公布的 IP 範圍,以及從 IP 反查網域名稱來確認 |
表裡最容易被誤會的是 Google-Extended。它只是一個寫在 robots.txt 裡的名字,Google 不會用這個名字來抓網頁,實際抓取還是由 Googlebot 這些既有的爬蟲在做,所以你在伺服器紀錄裡不會看到它。它管的是 Google 已經抓到的內容,能不能拿去訓練 Gemini,以及 Gemini 應用程式回答時能不能拿來當參考資料;而 Google 也寫明了它不影響搜尋的收錄,也不是排名訊號。
至於 AI 摘要和 AI 模式,Google 的說法是頁面只要被搜尋收錄、能顯示摘要,就有資格出現,沒有另外的條件,也沒有另外的爬蟲。所以想控制 AI 摘要可以用到你頁面上多少內容,要設的是 nosnippet 這類標記,細節在 nosnippet 能控制 AI Overviews 嗎。
OpenAI 的三個名字,加上一個只檢查廣告頁的 OAI-AdsBot,要怎麼分開設定和驗證,我另外整理在 OAI-SearchBot 與 GPTBot 怎麼分開設定。
把感測器公司的決定寫成 robots.txt
先寫路徑規劃表
動手改檔案之前,我會先把每個路徑放了什麼、要對誰開放寫成一張表。表裡的 Allow 是允許抓取,Disallow 是禁止抓取:
| 路徑 | 放了什麼 | AI 搜尋爬蟲 | 訓練用的名字 | 怎麼做 |
|---|---|---|---|---|
/products/、/blog/ | 產品頁、技術文章 | 允許 | 允許 | 不用另外寫規則 |
/whitepapers/ | 可以下載的技術白皮書 | 允許 | 禁止 | 在訓練用的那組規則寫 Disallow |
/preview/ | 還沒上線的草稿頁 | 禁止 | 禁止 | 每一組規則都寫 Disallow |
/dealer/ | 經銷商報價 | 不適用 | 不適用 | 改成登入後才看得到,不寫進 robots.txt |
經銷商報價之所以不寫進 robots.txt,是因為這個檔案任何人都打得開,把 /dealer/ 寫進去,等於把這個路徑告訴所有人。接著才把表格的決定寫成規則:
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /whitepapers/
Disallow: /preview/

User-agent: *
Disallow: /preview/

Sitemap: https://www.example.com/sitemap.xml第一組把四個訓練用的名字寫在一起,它們共用同一組規則;/preview/ 在兩組各寫一次的原因,下一段會講。如果你也不希望白皮書被收進公開的網頁資料集,可以把 User-agent: CCBot 加到同一組。
群組怎麼比對:爬蟲只讀名字相符的那一組
robots.txt 裡,以 User-agent 開頭、下面接著幾行規則的一段,叫做一個群組(group)。這份檔案能這樣寫,是因為 robots.txt 的規格(RFC 9309,2022 年發布的網路標準)規定,爬蟲會先找名字和自己相符的群組;找到了,就只照那一組的規則做,User-agent: * 那一組它不會再看。只有找不到自己名字的爬蟲,才會照 * 的規則。RFC 9309 第 2.2.1 節
所以 GPTBot 來抓 /preview/ 時,看的是第一組的規則;而 /preview/ 之所以要在第一組再寫一次,就是因為 * 那一組的限制它不會繼承。反過來,OAI-SearchBot、Claude-SearchBot、PerplexityBot 和 Googlebot 在這份檔案裡沒有自己的群組,所以都照 * 走:/preview/ 不能抓,白皮書可以抓。一旦替某個名字寫了專屬群組,* 裡的限制就要在那一組再抄一次,這是最常漏掉的地方。另外,同一個名字如果出現在好幾個群組,規格要求把這幾組合併起來看。
同一個網址同時符合 Allow 和 Disallow 時,看哪一條寫的路徑比較長,就照那一條;兩條一樣長時,規格建議爬蟲以 Allow 為準。例如白皮書裡有一份產品型錄摘要 /whitepapers/catalog-summary/,公司覺得給模型讀也沒關係,就在第一組多加一行 Allow: /whitepapers/catalog-summary/。因為它比 /whitepapers/ 長,所以這個子目錄會被放行,其他白皮書照樣擋住。
使用者觸發的請求和核對請求來源這兩件事,這份檔案管不到,我放在後面的檢查步驟處理。
robots.txt 擋不住想看的人
回到經銷商報價。被 robots.txt 擋住的網址,還是可能因為別的網頁連過去而被發現,而且每家平台遵守 robots.txt 的程度也不一樣,所以寫了 Disallow,只是對爬蟲提出一條請求,要保密的資料還是得靠登入和權限。
改完之後,從檔案一路檢查到伺服器紀錄
1. 列一張名字對照表
把平台、名字、用途和官方說明的網址記在同一張表。搜尋、訓練和使用者觸發的請求要分開記,不要混在一起寫。記到 Google-Extended 和 Applebot-Extended 時,另外註明「只寫在 robots.txt、不會自己來抓」,免得之後有人在伺服器紀錄裡找不到它們,以為設定沒生效。
2. 每一條規則寫上為什麼
例如「/whitepapers/ 不給訓練用,搜尋可以抓」。沒寫原因的 Disallow: /,半年後就沒有人敢動它,因為誰也說不清楚拿掉之後會影響什麼。
3. 實際打開 /robots.txt
確認網站回傳的是 200、內容是純文字,而不是 CDN 的錯誤頁。robots.txt 是每個網域、每種協定各一份,所以有 www 和沒有 www、http 和 https 都要打開看,確認讀到的是同一份。每次修改都把舊版和修改時間留下來,之後對照伺服器紀錄時,才知道爬蟲當時讀到的是哪一版。
4. 檢查重要頁面的回應
挑一篇技術文章、一個草稿頁和經銷商報價頁,各自看狀態碼(200 是正常、403 是拒絕存取、429 是請求太多被限制)、有沒有轉址、有沒有 noindex,以及正文是不是直接寫在回傳的 HTML 裡。經銷商報價頁在沒登入的情況下,應該要被擋住才對。反過來,robots.txt 放行了,頁面卻回 403,爬蟲一樣拿不到內容。
5. 核對 CDN 與網站防火牆
user-agent 這個欄位任何程式都能自己填,所以只看名字分不出真假。Perplexity 建議放行時,同時核對 user-agent 和它公布的 IP 範圍;Common Crawl 也提醒有人會冒用 CCBot 的名字,OpenAI 和 Anthropic 一樣公布了自己爬蟲的 IP 清單。例如紀錄裡有一筆自稱 GPTBot 的請求,來源 IP 卻不在 OpenAI 的清單上,那它就不是 OpenAI 的爬蟲。只比對 user-agent,冒名的請求也會被當成正牌爬蟲放進來。不過 Anthropic 也提醒,用 IP 擋它的爬蟲不一定穩定,想退出還是建議用 robots.txt 表達。
6. 讀伺服器紀錄,再實際問一次 AI
每一筆請求都要一起看時間、IP、user-agent、網址、狀態碼和回應大小。如果只知道某個 bot 來過,卻不知道它拿到的是 200、403 還是快取裡的舊頁面,這筆紀錄就說明不了頁面能不能被用。
最後再用同一組問題,去問 ChatGPT、Perplexity 或 Google 的 AI 摘要,記下回答引用了哪些網址、是哪一天問的。伺服器紀錄只能告訴你爬蟲來過、拿到了什麼,要知道 AI 回答有沒有用上你的頁面,還是得實際去問。這組問題不要寫成搜尋關鍵字,而是寫成客戶在找廠商時,實際會怎麼問 AI。因為客戶問 AI 的時候,通常會把自己的處境和條件一起講出來,回答引用的來源也會跟著不同:
| 關鍵字寫法 | 客戶實際會問 AI 的方式 |
|---|---|
| 工業感測器 廠商 | 我們工廠要在輸送帶上加溫度感測器,一次大概要 200 顆,台灣有哪些廠商可以客製? |
| 感測器 規格 | 食品廠的冷凍庫要裝溫濕度感測器,零下 30 度還能準確量測的有哪些? |
| 公司名稱 | 這家感測器公司有做工業用的溫度感測器嗎?交期大概多久? |
題目要分哪些類型、怎麼避免同一題換字重複,可以看 AI 搜尋題庫怎麼設計。而用同一組問題定期去問各家 AI、把回答和引用的網址保存下來,就是我們的 Otlex 在做的事,所以改了 robots.txt 之後,前後的回答能放在同一個地方對照。
robots.txt 管不到的事
robots.txt 只能表達你允許哪些爬蟲抓哪些路徑;而頁面會不會被收錄、被讀懂、被選成回答的來源,它都管不到。下面是我最常看到的幾個誤會:
| 常見誤會 | 實際意思 |
|---|---|
| OAI-SearchBot 拿到 200,ChatGPT 就會引用我 | 只代表這次抓取成功;會不會被引用,要看使用者問什麼、你的頁面有沒有回答到 |
| 擋了 GPTBot,OpenAI 就讀不到我的網站 | 只擋了訓練用的抓取,ChatGPT 搜尋和使用者要求開網頁的請求都不受影響 |
| 擋了 Google-Extended,AI 摘要就不會用我的內容 | Google-Extended 管的是 Gemini 的訓練和 Gemini 應用程式的引用;AI 摘要跟著 Google 搜尋的收錄走 |
| 網址在 sitemap 裡,每個 AI 都讀過了 | sitemap 只是告訴爬蟲有哪些網址,要不要讀、多久讀一次,由各家自己決定(細節在 sitemap 與 AI 爬蟲) |
| 防火牆放行了,內容一定會被用 | 只代表請求沒被擋,後面還有建立索引和挑選來源這兩關 |
Google 在 AI 功能的說明裡也寫到,就算頁面符合所有條件,Google 也不保證會收錄或在回答裡顯示它。其他 AI 產品也各有自己的流程,所以我會照上面的順序一層一層看。
回到感測器公司。你把 OAI-SearchBot、Claude-SearchBot、PerplexityBot 從那條 Disallow: / 裡拿掉,訓練用的名字只擋白皮書,經銷商報價改成登入後才看得到。隔天在伺服器紀錄看到 OAI-SearchBot 抓技術文章拿到 200,經銷商報價頁對沒登入的請求回 403;接著用那三題真實問法去問 ChatGPT,記下回答的來源有沒有出現官網。會不會被引用還要看題目和其他廠商的內容,但這一次,至少不是你自己把官網擋在門外。爬蟲讀得到之後,要追蹤品牌在 AI 回答裡有沒有被提到、引用和推薦,可以接著看 AI 能見度怎麼量和 AI 引用追蹤;要從 robots 規則一路確認到頁面內容實際抓不抓得到,則看 AI 爬蟲檢查表。
常見問題
robots.txt 能同時控制所有 AI 爬蟲嗎?
只能各家分開控制。每家的名字、用途和遵守 robots.txt 的程度都不一樣,像 Perplexity-User 這類使用者觸發的請求,官方文件就寫明一般會忽略 robots.txt。我會逐家把搜尋、訓練和使用者請求分開列,再決定哪些可以共用 * 群組。
封鎖 PerplexityBot 就能阻止 Perplexity 讀取所有頁面嗎?
擋得住搜尋用的抓取,但擋不住使用者觸發的請求。Perplexity 把 PerplexityBot 和 Perplexity-User 分開,後者是使用者提問時才去讀網頁,Perplexity 的文件寫明這類請求一般會忽略 robots.txt。真的要擋,就要靠網站防火牆、登入和伺服器權限。
Applebot-Extended 會讓頁面消失在 Apple 搜尋嗎?
不會。Applebot-Extended 只決定 Applebot 抓到的內容,能不能拿去訓練 Apple 的生成式 AI 模型,它本身不抓網頁,Apple 也寫明擋了它的頁面仍可能出現在搜尋結果。想連 Apple 的搜尋功能一起擋,要設的是 Applebot。
robots.txt 改好後,多久要重查?
OpenAI 寫的是大約 24 小時,Perplexity 寫最多 24 小時;robots.txt 的規格本身也要求爬蟲快取的版本不要用超過 24 小時。所以我會隔一天再看伺服器紀錄,確認各家爬蟲讀到的是新版,接著再用固定的問題去問 AI,看回答和來源有沒有跟著變。
參考來源
以下依各平台官方文件整理,user-agent 名稱、IP 範圍與 robots.txt 例外以官方頁面當下為準。
- Google Search Central:Introduction to robots.txt
- Google Crawling Infrastructure:Google-Extended
- Google Search Central:AI features and your website
- OpenAI Developers:Overview of OpenAI Crawlers
- Anthropic Help Center:Web crawlers
- Perplexity Developers:Perplexity Crawlers
- Apple Support:About Applebot
- Common Crawl:CCBot
- RFC Editor:RFC 9309 Robots Exclusion Protocol