
10 月 16 日,我在 Search Console 檢查我們自己的產品頁 ethorx.com/otlex。這一頁一直都列在 sitemap 裡,Google 也確實知道它存在,可是網址檢查顯示的狀態是「已找到 - 目前尚未建立索引」(英文介面是 Discovered – currently not indexed),也就是 Google 已經發現這個網址、但還沒來抓,上次檢索的時間是一片空白。同一天,「關於我們」這一頁也是一樣的狀態。
這就是 sitemap 能做和不能做的事。sitemap 讓 Google 知道有這一頁,這一步它做到了;但 Google 什麼時候來抓、抓了之後收不收錄,以及之後 ChatGPT 或 Google 的 AI 摘要會不會引用這一頁,都不是 sitemap 決定的。如果你是因為想讓 AI 找到你的網站才來查 sitemap,這一點要先知道。
這篇我會一直拿 ethorx.com 的 sitemap 和這兩頁當例子:先講 sitemap 能幫上什麼、跟 robots.txt、canonical(頁面上告訴搜尋引擎哪個網址是正式版本的標記)和內部連結怎麼分工,再講 XML 裡的網址和 lastmod 要怎麼整理,最後是從 sitemap 一路查到 AI 回答的六個檢查點,以及我們對這兩頁做了什麼。
sitemap 像是交給郵差的住戶名冊
- 名冊上列出社區裡有哪些門牌;sitemap 列出網站有哪些網址。
- 每一戶旁邊可以註明最近一次整修的日期;sitemap 的 lastmod 就是這個日期。
- 郵差拿到名冊,只是知道有這一戶,什麼時候去按門鈴,還是郵局自己排班;Google 拿到 sitemap,也是自己決定什麼時候來抓。
- 名冊上的地址如果有一半是空屋或已經拆掉,整修日期又每天都寫今天,郵差就會越來越不信這本名冊。
- 比喻在這裡不成立:郵差把信送到就結束了,Google 抓了頁面之後,還要決定收不收錄;AI 回答會不會引用它,又是另一件事。
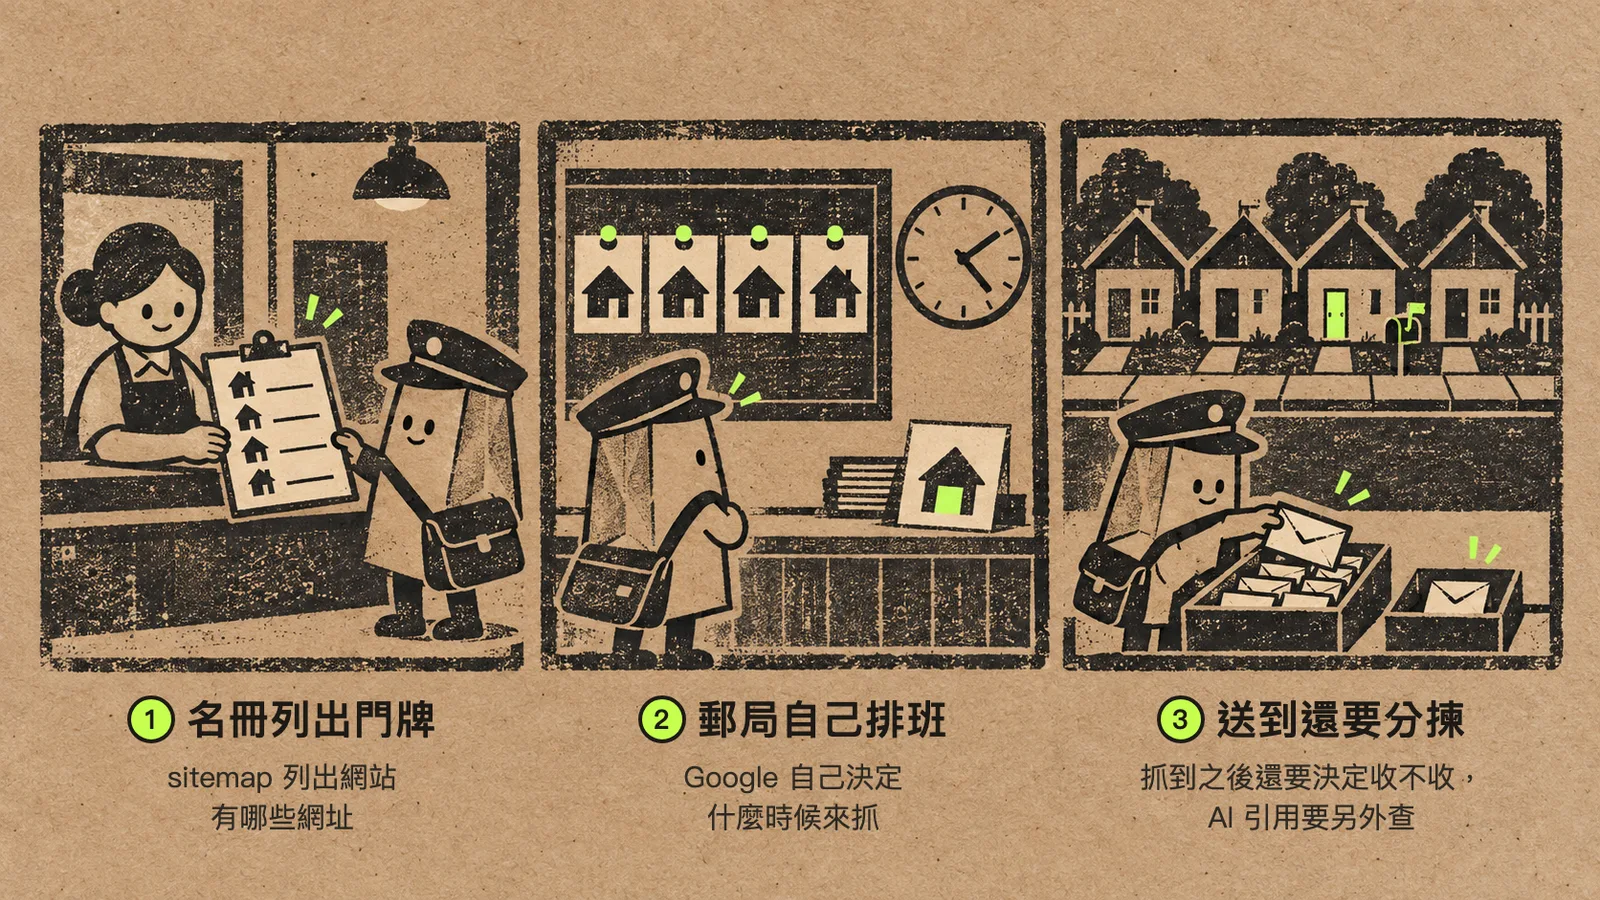 小郵差代表 Google 的爬蟲。名冊只負責告訴它有哪些門牌,什麼時候去、送到之後收不收,都是另外決定的。
sitemap 能幫上什麼、幫不上什麼
Google 的 sitemap 說明寫得很清楚:sitemap 是一份列出網頁和檔案的清單,能幫 Google 更有效率地檢索網站;而用了 sitemap,也不保證裡面每個網址都會被檢索和收錄。我們的 /otlex 就是一個例子:名冊上有,郵差還沒去。
同一份說明也列了哪些網站比較需要 sitemap:網站很大、新網站還沒有什麼外部連結,或有很多影片和圖片。反過來說,如果你的網站大約 500 頁以內、站內頁面都有互相連好,Google 說你可能不需要 sitemap;不過它也說,大多數網站放了 sitemap 還是會有幫助。以 ethorx.com 來說,網頁數在這個範圍內,文章之間也有互相連結,sitemap 對我們比較像是保險,讓新文章在還沒被其他頁面連到之前,Google 就先知道它存在。
sitemap 能回答的,是「網站希望搜尋引擎知道哪些網址」。下面這幾件事,它都回答不了,要另外查:
- 爬蟲有沒有被 robots.txt、網站防火牆、錯誤的狀態碼或登入機制擋下來。
- 頁面有沒有設 noindex(要求搜尋引擎不要收錄這頁的設定)、跟別頁內容重複,或 canonical 指向別的網址。
- 伺服器回傳的 HTML 裡,有沒有讀得到的正文(只靠 JavaScript 載入的內容,不是每個爬蟲都讀得到)。
- Google 有沒有真的把這一頁收進索引。
- AI 回答在某個問題上,有沒有引用這一頁。
各家 AI 爬蟲的名字怎麼在 robots.txt 裡設定,可以看 robots.txt 怎麼管理 AI 爬蟲。
sitemap、robots.txt、canonical 和內部連結怎麼分工
上面那些問題裡,爬蟲能不能進來、哪個網址算正式版本、新頁面有沒有路可以走到,分別由另外三樣東西管。這四樣常常被放在一起講,但它們各管一件事,混在一起檢查的話,出了問題就很難知道是哪一個出錯:
| 工具 | 它在做什麼 | ethorx.com 的做法 | 它管不到的事 |
|---|---|---|---|
| sitemap | 告訴搜尋引擎有哪些網址、什麼時候更新 | 文章、FAQ 和列表頁自動列進去,草稿不列 | 抓不抓、收不收錄 |
| robots.txt | 告訴爬蟲哪些路徑不要來抓 | 只擋 /api/ 和內部的設計頁,最後一行寫 sitemap 的位置 | 不能用來把頁面從搜尋結果藏起來 |
| canonical | 告訴 Google 幾個重複網址裡哪一個是正本 | 每頁都指向自己的正式網址 | Google 還是可能選別的網址 |
| 內部連結 | 讓爬蟲和讀者從一頁走到另一頁 | 每篇文章都連到上層的主題文章和幾篇相關文章 | AI 會不會引用 |
這裡有兩個細節值得記住。
第一,Google 的 canonical 說明把轉址和 rel="canonical" 列為比較強的提示,而網址有沒有列在 sitemap 裡,只是比較弱的提示;所以 sitemap 列的網址和頁面上的 canonical 不一樣時,頁面上的 canonical 分量比較重。不過最後選哪一個,還是 Google 自己判斷。
第二,Google 的 robots.txt 說明提醒,robots.txt 是用來管理爬蟲流量的,不是讓網頁不出現在 Google 的方法;要讓頁面不被收錄,要用 noindex,而且不能同時用 robots.txt 擋住它,否則 Google 連 noindex 都看不到。
XML sitemap 裡的網址要怎麼整理
sitemap 裡的每一個網址,都應該是你真的希望被收錄、而且任何人都打得開的正式網址。以 ethorx.com 來說,我們的 sitemap 是程式依照內容自動產生的,規則是這樣:
- 已發布的文章和 FAQ 列進去,還在寫的草稿不列。
- 內容已經併進另一篇長文、設了 noindex 的 FAQ 不列。
- 還沒有任何文章的作者頁,也設了 noindex、不列進 sitemap。
你的網站不一定要用程式產生,但可以照這幾個原則逐條檢查:
- 網域和協定統一:網址用 https 和同一個網域,例如統一用
https://www.開頭,不要有的有 www、有的沒有。 - 每個網址都打得開:不用登入就打得開,伺服器回的是代表正常的 200 狀態碼。404(找不到)的頁面不該列,301(轉址)的舊網址也不該列,改列轉址後的新網址。
- 和 canonical 一致:網址和頁面上的 canonical、站內連結指向同一個版本,不要 sitemap 列一個、canonical 又指向另一個。
- 不列不該收錄的頁:不要列草稿、404、會轉址的舊網址,或設了 noindex 的頁面。
- 不超過上限:檔案用 UTF-8 編碼;Google 的建立 sitemap 說明寫的是一個檔案最多 50,000 個網址、未壓縮 50 MB,超過就拆成多個檔案,再用一份 sitemap index(列出其他 sitemap 位置的總表)把它們串起來。網站很大時,也可以照內容類型拆檔,例如商品、分類、文章各一份,哪一份的網址數突然掉了,就知道是哪一類內容出了問題。
lastmod 只在內容真的改了才更新
lastmod 是每個網址旁邊的「最後修改日期」,也就是名冊上的整修日期。Google 的建立 sitemap 說明寫到,它只有在這個日期一直都準確、而且查得到對應的修改時,才會參考 lastmod;而所謂的修改,指的是正文、結構化資料或連結這類重要的更新,像頁尾的版權年份更新就不算。另外,sitemap 裡的 <priority> 和 <changefreq>,Google 是直接忽略的。
ethorx.com 的做法是:文章的 lastmod 直接用文章的「更新日期」欄位,只有我們真的改過那篇文章,這個日期才會變;分類頁和專欄首頁的 lastmod,則取它列出的文章裡最新的那個日期,因為有新文章上線,列表頁的內容也跟著變了。而關於我們、聯絡頁和 /otlex 這些固定頁,因為沒有可靠的更新紀錄,我們就乾脆不寫 lastmod。所以 /otlex 沒被抓,跟 lastmod 無關:它本來就沒有這個日期,Google 是靠網址清單和站內連結知道它的。
有一種錯誤很容易發生:網站每次重新建置,就把所有網址的 lastmod 改成今天。這樣這個日期就對不上實際的修改,而 Google 只參考一直準確的 lastmod,你的日期就可能被當成不可信。所以如果你的平台沒辦法給出準確的更新日期,寧可不填,也不要填一個每天都在變的日期。
Search Console 顯示 sitemap 提交成功,只代表 Google 讀到了這份清單,清單上的網址有沒有被收錄,要到網頁索引報表去看;AI 回答有沒有引用,則要另外實際去問。
從 sitemap 到 AI 回答的六個檢查點
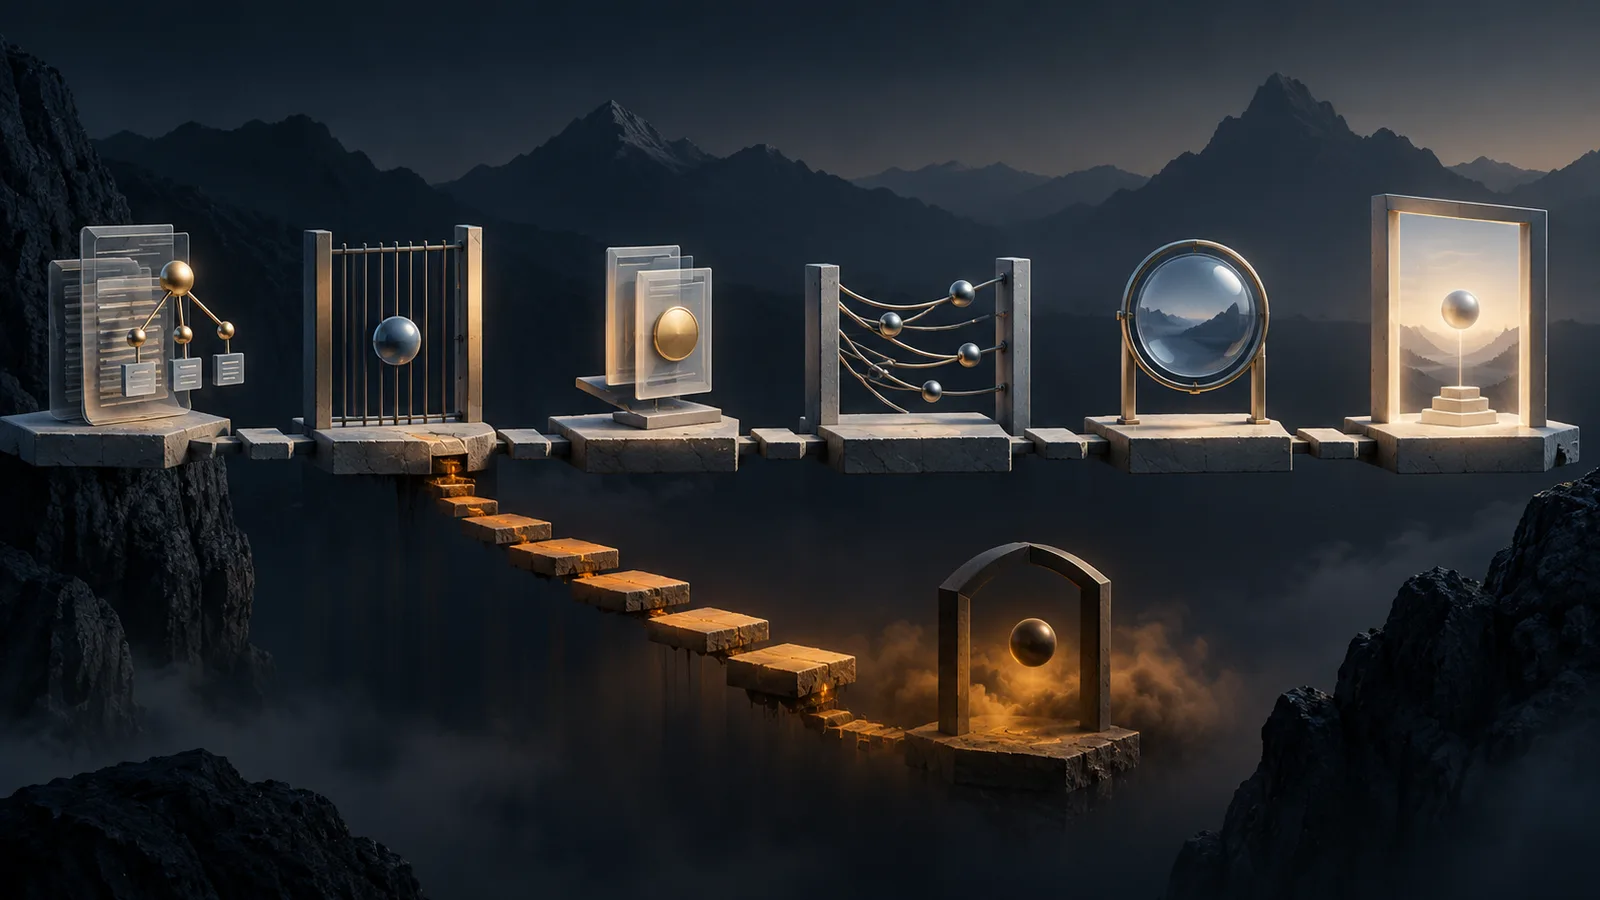 sitemap 負責告訴搜尋引擎有哪些網址;後面的抓取、收錄和 AI 引用,要一層一層分別確認。
新文章上線後,我會照下面這六個檢查點一個一個看。前五個是 Google 這條路的順序,前一個沒過,後面就先不用查。第六個是 AI 回答,ChatGPT、Perplexity 這些產品各自決定引用哪些來源,所以要另外查:
| 檢查點 | 去哪裡看 | 正常的樣子 | 不正常時先查什麼 |
|---|---|---|---|
| 網址清單 | 直接打開 sitemap.xml | 新文章的網址在裡面,草稿和已刪的頁不在 | 產生 sitemap 的規則或外掛設定 |
| XML 格式 | Search Console 的「Sitemap」報表 | 狀態是「成功」,探索到的網頁數跟你預期的差不多 | 出現「無法擷取」或「有錯誤」時,先查檔案格式和網址 |
| 回應狀態 | 打開瀏覽器的開發者工具(Windows 按 F12,Mac 按 Option+Command+I),切到「Network」分頁後重新整理,看清單最上面那一筆的 Status | sitemap 和新文章都是 200 | 出現 301(轉址)、404(找不到)或 5 開頭的伺服器錯誤 |
| 存取規則 | robots.txt、頁面原始碼裡的 noindex 和 canonical | 沒被擋、沒有 noindex、canonical 指向自己 | 外掛或範本有沒有自動加上 noindex |
| 收錄 | Search Console 的「網址檢查」 | 顯示「網址在 Google 服務中」 | 展開「網頁索引狀態」看 Google 給的原因 |
| AI 回答 | 拿固定的問題實際去問 ChatGPT、Gemini 或 Google 的 AI 摘要 | 回答附上的來源裡有這一頁 | 換幾天再問一次,並記下日期 |
我們的 /otlex 就是停在第五個檢查點。前四個都正常:sitemap.xml 裡有 https://www.ethorx.com/otlex 這一行,Search Console 的 Sitemap 報表是「成功」,開發者工具看到的是 200,robots.txt 只擋 /api/ 和 /design-system,頁面上的 canonical 也指向自己。可是到了第五個,網址檢查顯示 Google 還沒來抓。報表只給「已找到 - 目前尚未建立索引」這個狀態,不會說明為什麼延後。前五個檢查點都可以從自己的網站和 Search Console 查到,只有最後一個要實際去看 AI 怎麼回答。
以 Google 來說,它的 AI 功能說明寫到,網頁要出現在 AI 摘要或 AI 模式裡,條件是已經被收錄、而且符合在搜尋結果顯示摘要的資格,不需要另外做什麼 AI 專用的設定。所以就 Google 而言,前五個檢查點都過,只代表條件備齊了,要不要拿來用,還是 Google 決定。
至於 OpenAI、Anthropic、Perplexity 這些公司的爬蟲,想知道它有沒有來抓過你的頁面,最直接的方法是看網站主機或防火牆服務(例如 Cloudflare 這類 CDN)的存取紀錄,裡面會記下每個爬蟲的名字和它請求了哪些網址;我們開發的 Otlex 也會記錄 AI 爬蟲造訪網站的紀錄。
查 AI 回答時有一點要注意:某一天問了沒看到這一頁,只代表那一天、那個問題、那個產品的回答沒有引用它。不要把它記成「AI 沒有收錄這頁」,換幾天、用同一組問題再問,才比較得出來有沒有在變。問題怎麼寫成顧客真的會問的樣子,可以看 AI 搜尋題庫怎麼設計。
回到 /otlex:我們怎麼處理
查完六個檢查點,/otlex 和關於我們這兩頁卡在同一個地方:sitemap 有列、網址打得開、沒有被擋,只是 Google 還沒來抓。sitemap 已經交過了,再交一次也只是讓 Google 再讀一次同一份清單,所以我們在 Search Console 的網址檢查裡,替這兩頁各送出一次建立索引的要求,請 Google 來抓。
送出之後狀態不會馬上變,我們會在一週後用同一個工具看「網頁索引狀態」:上次檢索的時間出現了,代表 Google 來過;狀態變成「網址在 Google 服務中」,才算收錄。這兩頁到時候如果還是停在原地,下一步會從更多文章連過去,讓 Google 從更多頁面發現它們。
常見錯誤與修正
sitemap 交了卻沒被抓,或報表數字對不上,可以對照下面這幾個常見錯誤。
只交 sitemap,站內沒有連結
新文章只出現在 sitemap 裡,站上沒有任何一頁連到它,讀者找不到,爬蟲也只能從 sitemap 知道它存在,看不到其他頁面怎麼描述它。修正方式是從上層的主題文章、分類頁或相關文章各連一次過去,連結文字直接寫這篇在講什麼,例如「sitemap 能讓 AI 爬蟲找到你的網頁嗎」。sitemap 只是補一條路,站內連結還是要自己排好,怎麼排可以看內部連結會讓 AI 更常引用你嗎。
sitemap 裡列了一堆打不開的網址
改版或搬家後最常發生:sitemap 還列著已經刪掉的頁、會轉址的舊網址,或設了 noindex 的頁面。結果 Search Console 裡探索到的網頁數,跟網站實際上想被收錄的頁面數對不上,你就很難從報表看出哪些頁真的有問題。先把 404、轉址和 noindex 的網址清掉,再重新提交。
以為改了 lastmod,AI 就會更新回答
lastmod 只是告訴搜尋引擎這一頁什麼時候改過,爬蟲不會因此馬上來抓,AI 回答也不會因此跟著變。要確認爬蟲來過,看伺服器的存取紀錄;要確認 AI 回答更新了,用同一組問題實際去問。
sitemap 的網址和頁面上的 canonical 不一致
例如 sitemap 列的是有結尾斜線的 /geo/,頁面上的 canonical 卻是 /geo。Google 看到兩個不一樣的提示,就要自己判斷哪個才是正本。修正時把 sitemap、canonical、站內連結和轉址一起改成同一個版本;canonical 跟 AI 引用網址的關係,在 canonical 會影響 AI 引用哪個網址嗎有完整說明。
常見問題
sitemap 能確保 AI 爬蟲找到頁面嗎?
不能。sitemap 能讓搜尋引擎更快知道網址存在,但 Google 自己就說不保證每個網址都會被檢索和收錄。其他 AI 爬蟲公開的說明沒有講到 sitemap;想確認它們有沒有來過,要看網站主機或防火牆的存取紀錄。
用 robots.txt 擋住的網址,放進 sitemap 還有用嗎?
爬蟲可能從 sitemap 知道這個網址存在,但因為被 robots.txt 擋住,它還是抓不到內容。如果你的目的是不讓這一頁被收錄,應該讓爬蟲抓得到、在頁面上設 noindex,而不是用 robots.txt 擋;被擋住的話,爬蟲連 noindex 都看不到。
sitemap 裡應該放 canonical 網址嗎?
應該。sitemap 只放每一頁的正式網址,也就是頁面 canonical 指向的那一個,並且讓站內連結和轉址都指向同一個版本。這幾個提示互相矛盾時,Google 會自己選一個,而選出來的未必是你要的。
lastmod 越新,越容易被 AI 引用嗎?
不會。lastmod 只是告訴搜尋引擎頁面什麼時候改過,而 AI 引用哪一頁,是產品在回答時自己挑來源的結果。每天把所有網址的 lastmod 刷新一次、內容卻沒變,反而會讓 Google 不再參考這個欄位。
sitemap 提交了,報表卻沒有資料,是失敗了嗎?
先別急著判斷失敗。剛提交的 sitemap,Search Console 可能要過幾天才會顯示讀取結果;你可以先確認提交的是正確的網址、檔案本身打得開,而且是在對應這個網域的 Search Console 資源(你在 Search Console 加入並驗證過的那個網站)底下提交的。這幾項都沒問題的話,就等幾天再回來看。