
你在一家做會計軟體的公司負責官網,網站上有一頁「方案比較」,把三種方案的價格和功能都列得很清楚。你想知道 ChatGPT 讀不讀得到這一頁,於是用瀏覽器打開,頁面正常顯示,開發者工具也寫著 200。可是你改用 OpenAI 搜尋爬蟲 OAI-SearchBot 的名字重送一次請求,拿到的卻是 403,也就是伺服器拒絕了這個請求。
這代表什麼?瀏覽器看到 200,只能說明你自己這台電腦在那個時間點打得開這一頁;而爬蟲會不會被擋、拿到的內容讀不讀得懂,是另外兩件事,要分開查。我這篇會一直拿這個「方案比較」頁當例子,先講「讀得到」包含哪幾件事,再照八層檢查表一層一層走,看它除了 403 之外還有哪裡出問題、最後怎麼修好,文末也附上我們拿 ethorx.com 跑同一套檢查的結果和檢查程式。
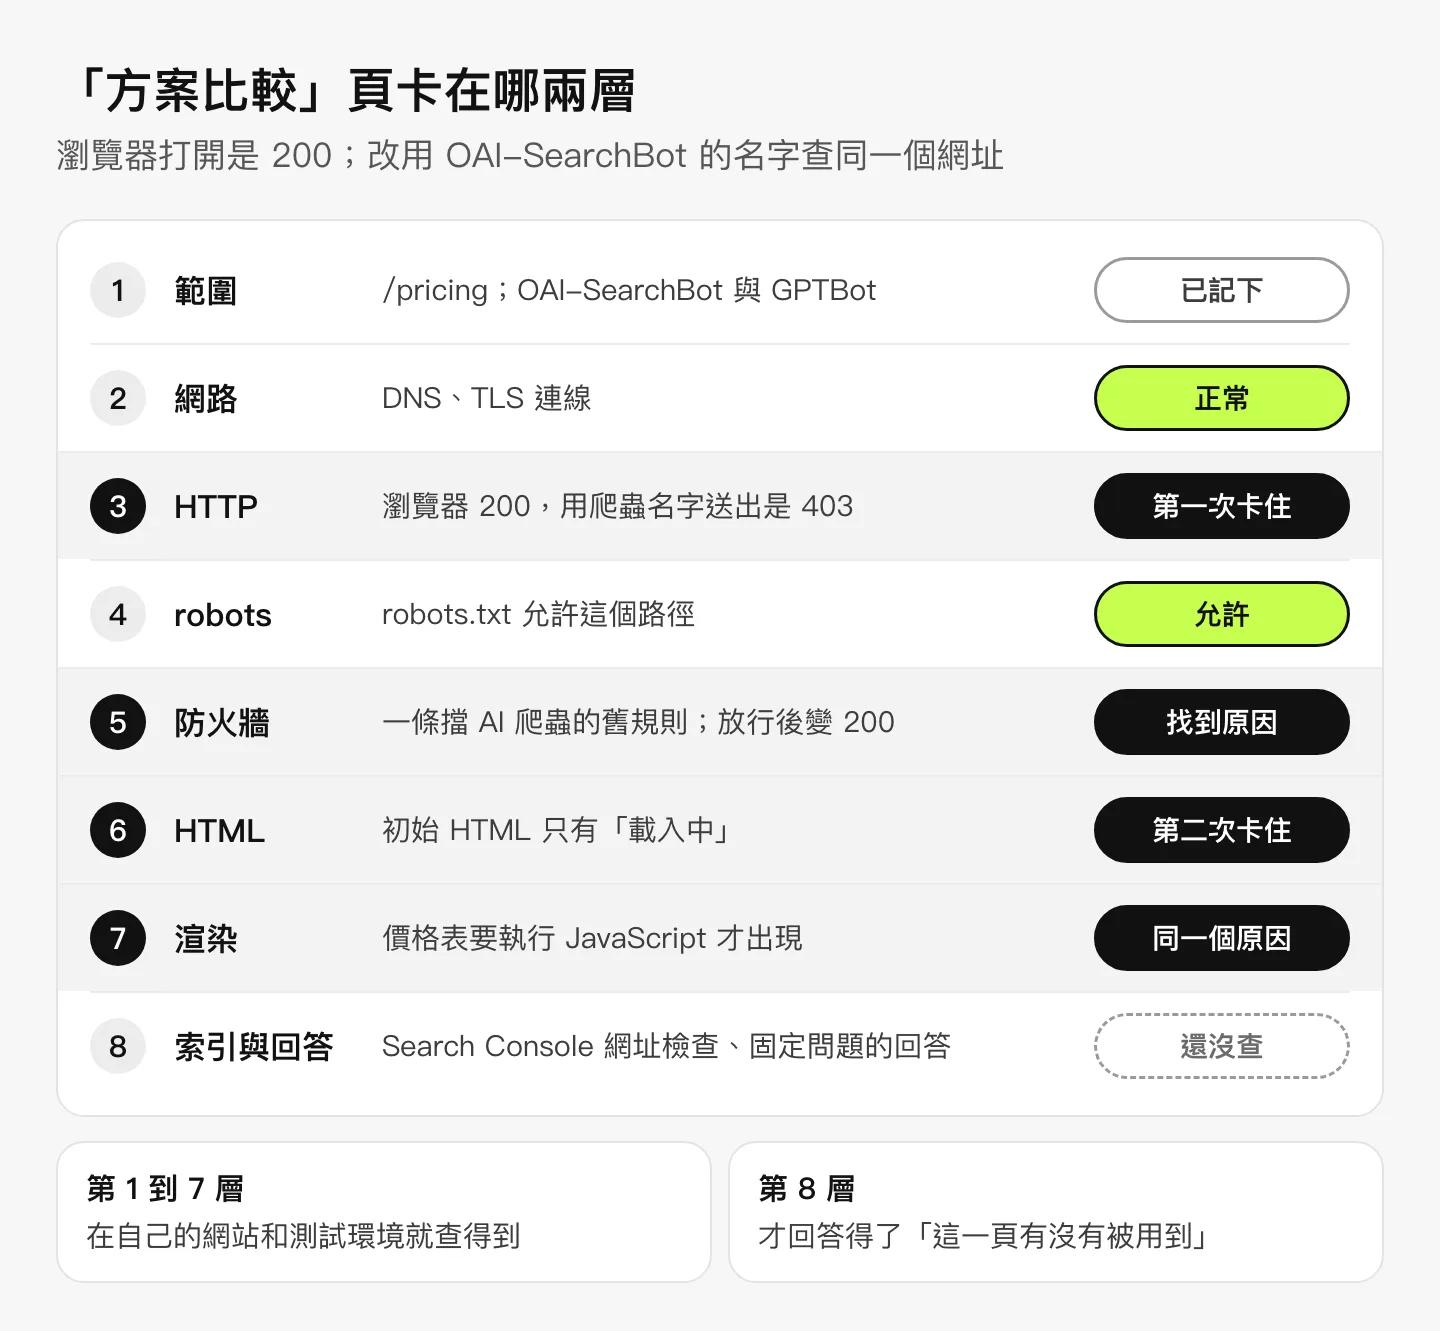 瀏覽器看到 200,爬蟲卻先在 HTTP 那一層拿到 403,原因在防火牆;放行之後又卡在 HTML,因為價格表要等 JavaScript 才出現。每一層的結果都要分開記,索引和 AI 引用則要另外查。
「讀得到」包含哪三件事
我會把「AI 爬蟲讀得到這一頁」拆成三件事:指定的爬蟲連得上網站、它的請求拿到正常的回應,以及回應裡有讀得懂的內容。拿「方案比較」頁來說,那個 403 就是第二件事出了問題。這三件事都通過了,才算爬蟲讀得到這一頁,而 AI 產品最後會不會用這一頁回答問題,則是第四件事,要看是哪個產品、哪一個問題。對到下面的八層檢查表,第 2 層查連不連得上,第 3 到 5 層查回應正不正常,第 6、7 層查內容讀不讀得懂,第四件事就是第 8 層。
為什麼用瀏覽器打開不能算數?因為你的瀏覽器送出的請求,帶著你的 IP 位址、登入狀態和所在地區,而且會執行 JavaScript;爬蟲送出的請求,這幾項通常都不一樣。網站防火牆和 CDN(把網站內容放到各地伺服器加速的服務)也可能依這些條件,對兩種請求做出不同的處理。
Google 的文件也是把這幾件事分開講的。robots.txt 介紹寫到,robots.txt 主要是用來管理爬蟲的抓取流量,它沒辦法讓網頁不出現在 Google;而 AI 功能說明則寫到,頁面要被編入索引、而且符合顯示摘要的條件,才有資格成為 AI 摘要和 AI Mode 裡的支援連結,同時也提醒編入索引和顯示都沒有保證。所以從「robots.txt 寫了 Allow」到「會被 AI 引用」,中間還隔著好幾層要確認。
各家 AI 爬蟲的名字和用途,我另外整理在 robots.txt 怎麼管理 AI 爬蟲;這篇就不重複列每一家,只講一套可以套到任何一個爬蟲、任何一個網址的檢查順序。
八層檢查表總覽
下面這張表的最後一欄,是「方案比較」頁在每一層查到的結果:
| 層次 | 要回答的問題 | 看什麼 | 「方案比較」頁的結果 |
|---|---|---|---|
| 1. 範圍 | 查哪個網址、哪個爬蟲、什麼時間? | 完整網址、爬蟲名稱、檢查時間 | /pricing;OAI-SearchBot 與 GPTBot |
| 2. 網路 | 網域解析和加密連線正不正常? | DNS 解析、TLS 連線的結果 | 正常 |
| 3. HTTP | 伺服器回了什麼狀態? | 狀態碼、回應標頭、轉址過程 | 瀏覽器 200;用爬蟲名字送出是 403 |
| 4. robots | robots.txt 允不允許這個路徑? | 當天的 robots.txt 內容 | 允許 |
| 5. 防火牆 | 防火牆有沒有放行真的爬蟲? | 防火牆事件紀錄、放行規則 | 有一條擋 AI 爬蟲的舊規則,拿掉後變 200 |
| 6. HTML | 原始碼裡有沒有標題、正文和連結? | 伺服器第一次回傳的 HTML | 只有「載入中」 |
| 7. 渲染 | 主要內容要不要靠 JavaScript? | 執行 JavaScript 後的頁面內容 | 價格表要執行 JavaScript 才出現 |
| 8. 索引與回答 | 頁面有沒有被索引、有沒有被回答用到? | Search Console 網址檢查、固定問題的回答紀錄 | 還沒查 |
前七層大多在你自己的網站、防火牆紀錄和測試環境就查得到;第八層則要用 Search Console 和固定的一組問題去看,它是唯一能回答「這一頁有沒有被用到」的一層。「方案比較」頁的 403 會出現在兩層:第三層看到被拒絕,第五層才找到是哪一條規則擋的。所以我會建議你照順序查,但每一層的結果都單獨記下來,之後要修 robots、防火牆還是 HTML,看紀錄就知道。
逐層執行 AI 爬蟲檢查
1. 範圍:先決定要查哪個網址、哪個爬蟲
先把完整網址、要模擬的爬蟲和檢查時間寫下來。只查首頁的話,結論就只適用首頁,因為產品頁、圖片和 API 可能走不同的路由和防火牆規則。「方案比較」頁這次查的是 OAI-SearchBot 和 GPTBot 兩個名字,前者是 OpenAI 用來讓網站出現在 ChatGPT 搜尋功能的爬蟲,後者則是蒐集可能用來訓練模型的內容,兩者的用途不一樣,被擋的結果也可能不一樣。要比較不同爬蟲時,用同一個網址、在同一個時段測,因為防火牆的規則和快取,都可能讓相隔一小時的兩次測試得到不同結果。
2. 網路:DNS 和 TLS 連不連得上
DNS 是把網域名稱轉成伺服器位址的服務,TLS 則是 HTTPS 的加密連線;這兩層出問題時,請求根本到不了網站。最簡單的測法,是用無痕視窗打開網址,網址列出現鎖頭、沒有憑證錯誤;下一層的 curl 指令如果直接回「Could not resolve host」或憑證錯誤,問題就在這一層。「方案比較」頁這一層正常。
3. HTTP:伺服器回了什麼狀態
接著看 HTTP 回應:狀態碼、內容類型,以及中間有沒有轉址。可以請工程師用 curl 這個命令列工具,指定 user-agent(爬蟲在請求裡自報的名字)送出請求:
curl -I -L -A "OAI-SearchBot/1.4" https://example.com/pricing-I 只要回應標頭、不下載內容,-L 會跟著轉址走到最後一頁。有些防火牆對「只要標頭」和「要完整內容」的請求處理不一樣,所以看到奇怪的結果時,拿掉 -I 再送一次。要注意的是,這只是借用爬蟲的名字送出請求,真正的爬蟲還會帶著它自己的 IP 和其他標頭,所以結果只能當參考。
「方案比較」頁在這一步就看到差異了:同一個網址,瀏覽器拿到 200,換成爬蟲的名字卻是 403。看到 401(要登入)、403(被拒絕)、429(請求太頻繁)、5 開頭的伺服器錯誤,或一長串轉址時,先找出是哪一關回的。
4. robots:robots.txt 允不允許
把檢查當天的 robots.txt 存下來,逐條對照 User-agent、Allow、Disallow 和 Sitemap(告訴爬蟲網址清單放在哪裡的那一行)。「方案比較」頁的網站只寫了 User-agent: * 加上 Allow: /,所以每個爬蟲都被允許。如果檔案裡有針對某個爬蟲名字寫的區塊,例如 User-agent: GPTBot,那個爬蟲就只遵守寫給它的那一段規則,不會再看 * 那一段,這是 robots.txt 的標準規格 RFC 9309 的規則。
另外兩件事也要記得。第一,robots.txt 管的是能不能抓取,收錄要另外看:Google 的文件提醒,被 robots.txt 擋住的網址如果有別的網站連過來,還是可能出現在搜尋結果裡,只是沒有說明文字;真的不想被收錄,要用 noindex(寫在頁面上、要求搜尋引擎不要收錄的指令),而且要讓爬蟲讀得到這個指令。第二,robots.txt 是請爬蟲配合的規則,不能當成存取權限的控管;Google 和其他有信譽的爬蟲會遵守,但不是每個爬蟲都會。
5. 防火牆:有沒有放行真的爬蟲
網站防火牆(WAF)會依照 IP、網路業者、請求標頭、請求頻率或地區,判斷要不要擋下一個請求;其中依頻率擋的叫速率限制,同一個來源短時間內送太多請求,就會開始收到 429。「方案比較」頁的 403 就是在這一層找到原因的:防火牆裡有一條擋 AI 爬蟲的舊規則,是之前為了擋大量抓取加上去的,後來一直沒有拿掉。你把這條規則刪掉之後,再用 curl 送一次,就變成 200 了。
刪掉舊規則之後,如果還想對爬蟲做限制,要小心一件事:user-agent 是請求自己填的,任何人都可以假冒成 OAI-SearchBot。Google 的常見檢索器文件就提醒 user-agent 可能被偽造,建議用 Google 公布的 IP 範圍,或用 IP 反查主機名稱(反向 DNS)來確認來源;OpenAI 也在它的爬蟲說明公布了各個爬蟲的 IP 範圍。所以只靠名字放行,等於讓任何自稱是爬蟲的請求都進得來,比較穩的做法是比對官方公布的 IP 範圍,或用防火牆服務內建的爬蟲驗證功能。
網站的存取紀錄裡,403 和 429 也要一起看。同一個網址在不同時間拿到不同回應時,把快取、流量負載和規則有沒有改過一起記下來,免得把某一次成功的請求,當成這一頁一直都讀得到。
6. HTML:原始碼裡有沒有主要內容
防火牆放行之後,你拿掉 -I 再送一次 curl,這次拿到完整的 HTML,才發現「方案比較」頁的問題出在下一層:伺服器第一次回傳的 HTML,也就是還沒執行任何 JavaScript 的初始 HTML,裡面只有一個寫著「載入中」的區塊,價格表一個字都沒有。
我會建議標題、主要文字、內部連結、canonical(告訴搜尋引擎哪個網址是正式版本的標記)和 robots 指令,至少要出現在初始 HTML 裡。如果你的網站有好幾個網址指向同一頁,記錄時也要寫下 canonical 宣告的是哪一個,細節在 canonical 會影響 AI 引用哪個網址嗎。
7. 渲染:主要內容要不要靠 JavaScript
價格表要等瀏覽器執行完 JavaScript 才組出來。這個「瀏覽器執行 JavaScript、把內容畫到頁面上」的過程叫做渲染。Google 的 JavaScript SEO 基本知識說明,Google 處理 JavaScript 網頁會經過檢索、轉譯(也就是渲染)和建立索引三個階段,同時也提醒並不是所有爬蟲都能執行 JavaScript。也就是說,Google 也許等得到價格表,但其他 AI 爬蟲如果不執行 JavaScript,它們拿到的就只有「載入中」三個字。
檢查時把原始碼和執行後的頁面分開看:curl 拿到的是初始 HTML,而瀏覽器開發人員工具的 Elements 面板裡看到的,是執行 JavaScript 之後的結果。要記下的是原始回應,畫面截圖只能看出瀏覽器顯示了什麼。各家爬蟲會不會執行 JavaScript 還不清楚時,結論就只寫到你測過的那幾個爬蟲。更細的檢查步驟在 JavaScript SEO 怎麼檢查。
8. 索引與回答:頁面有沒有被用到
最後一層要到網站之外去看:
- 頁面有沒有被索引:用 Search Console 的網址檢查輸入這個網址,看「網頁索引狀態」,顯示「網址在 Google 服務中」才算收錄;Bing 等其他搜尋引擎,則看它們各自的站長工具。
- 真正的爬蟲有沒有來過:調出防火牆或主機這段期間的存取紀錄,用官方公布的 IP 範圍比對。我們開發的 Otlex 也會記錄 AI 爬蟲造訪網站的紀錄,可以拿來對照。
- AI 回答有沒有用到:用一組固定的問題,在同樣的 AI 產品裡隔幾天重問幾次,記下回答和引用的網址。
這組問題,要寫成買會計軟體的人真的會問 AI 的樣子,而不是搜尋關鍵字:
| 關鍵字寫法 | 實際會問 AI 的方式 |
|---|---|
| 會計軟體 價格 | 我們是 8 個人的貿易公司,要開發票也要管庫存,哪一套會計軟體一個月 3,000 元以內做得到? |
| 會計軟體 比較 | 小公司用雲端會計軟體,跟請記帳士用他們的系統比起來,哪個比較划算? |
題目怎麼設計,可以看 AI 搜尋題庫怎麼設計。
回到「方案比較」頁:修好之後的紀錄
找到兩個問題之後,你請工程師把價格表改成在伺服器端產生 HTML,也就是伺服器回傳的第一份 HTML 裡就已經有價格,不必等瀏覽器執行 JavaScript。改完再用 curl 送一次,初始 HTML 裡已經看得到三個方案的價格和功能。
接著把這一輪的結果記下來。每一層分開寫,「規則允許」和「真的讀到」也分開寫:
| 項目 | 這次的結果 | 怎麼看 |
|---|---|---|
| 網址 | https://example.com/pricing | 用正式網址;帶參數的要寫清楚是哪些參數 |
| 爬蟲 | OAI-SearchBot(GPTBot 被同一條舊規則擋下,刪除後也是 200) | 寫上名字的出處,例如 OpenAI 的爬蟲說明 |
| robots.txt | 允許 | 只說明規則允許,抓不抓得到看 HTTP |
| HTTP | 200(刪掉舊規則前是 403) | 這只是這一次請求的結果 |
| 防火牆 | 舊規則已刪除 | 要有規則或事件紀錄可以對照 |
| HTML | 初始 HTML 有價格表(修改前只有「載入中」) | 寫明看的是原始碼,還是執行 JavaScript 之後的頁面 |
| 索引 | 已送出網址檢查,等 Google 重新檢索 | 用 Search Console 的網址檢查 |
| AI 回答 | 第一次用上面兩題問過,回答還沒有引用這一頁 | 隔一週用同樣的問題、同樣的 AI 產品再問 |
每一層分開寫,下次要修的時候,就知道問題出在防火牆還是 HTML。AI 回答那一項只問過一次,一次沒看到引用,推不出「AI 不用這一頁」的結論,要等同一組問題問過幾輪再看。
同樣的檢查,拿 ethorx.com 跑一次
我也拿我們自己的網站跑過同一套檢查。2026 年 10 月 17 日,我們用一支自己寫的檢查程式,把 ethorx.com 正式 sitemap(網站提供給搜尋引擎的網址清單)上的網址全部抓一次,看每一頁的 HTTP 狀態、標題、說明、H1(頁面上最主要的標題)、canonical 和 noindex。這支程式涵蓋的是第 3、4、6 層,它會先讀 robots.txt,當天這些網址都沒有被擋。sitemap 上有 155 個網址:
| 檢查項目 | 結果 | 這個結果說明什麼 |
|---|---|---|
| HTTP 200 | 155/155 | 這次的請求都成功了 |
| 標題與說明都有 | 155/155 | HTML 裡有這兩個欄位,文案寫得好不好要另外看 |
| 只有一個 H1 | 155/155 | 每一頁都找到一個 H1 |
| canonical 指向自己 | 155/155 | 網站自己的宣告一致,Google 採不採用要另外看 |
| 含 noindex | 0/155 | 沒有一頁被設定成不收錄 |
我們 10 月 3 日第一次跑的時候,sitemap 上只有 135 個網址,五項也都通過。數字會變,是因為這兩週網站多了文章;所以重跑的結果和上次不一樣時,先比網址清單和日期,再下結論。另外,10 月 17 日當天我也用 GPTBot、OAI-SearchBot、ClaudeBot、PerplexityBot 和 Googlebot 的名字,各送一次請求到 /blog/what-is-seo,五個都拿到 200,回傳的 HTML 大小也和一般請求一樣,裡面就有標題和正文。
這個結果能說明的是:用這些名字送出的請求沒有被擋,而且初始 HTML 裡就有內容,因為我們的網站是在伺服器端產生 HTML 的。它說明不了真正的爬蟲從它們自己的 IP 來時會不會被擋,也查不到索引和 AI 回答,那些是第五層和第八層要另外查的事。
你可以下載 10 月 17 日的逐頁結果和檢查程式,在裝了 Python 3 的電腦上自己跑一次。程式只用 Python 內建的函式庫,不需要 API 金鑰;它會先讀 robots.txt,抓不到的頁面也會另外列出來,不會算成通過:
python3 audit-public-seo.py --base https://www.ethorx.com --out audit.json換成自己的網域時,把 --base 改成你的網址就可以了。這個簡化版只讀根目錄的 sitemap.xml,最多 300 頁;如果你的 sitemap 是再分成好幾個檔案的索引檔,要先自己拆成網址清單。
常見問題
robots.txt 允許 AI 爬蟲,頁面就會被引用嗎?
不一定。robots.txt 只管爬蟲能不能請求這個網址,後面還有 HTTP 回應、防火牆、HTML 內容、索引,以及 AI 產品要不要用這一頁。「方案比較」頁就是 robots.txt 允許、防火牆卻回 403 的例子。指定的問題裡沒看到引用時,把問題和日期記下來,過一段時間用同樣的問題再看一次。
一個 200 回應就足以證明 AI 爬蟲能讀內容嗎?
200 只說明那一次請求成功了。你還要看回傳的內容類型、內容完不完整、有沒有要求登入、主要內容需不需要 JavaScript,以及指定的爬蟲實際拿到什麼。同一個網址回 200,內容也可能只是「請先登入」或「載入中」。如果你只用瀏覽器測過,爬蟲的結果就先記成還沒查。
防火牆只用 user-agent 放行可以嗎?
可以當規則的一部分,但我不建議只靠它,因為 user-agent 是請求自己填的,任何人都能假冒成知名的爬蟲。要確認真的是官方爬蟲,照各家官方文件比對 IP 範圍或反向 DNS,Google 和 OpenAI 都有公布。拿不到這些資料時,就在紀錄裡寫明「目前只依名字放行」,之後要調整規則時才知道它的限制。
AI 爬蟲抓得到圖片,就代表讀得懂文章嗎?
這兩件事要分開看。文章讀不讀得懂,看的是 HTML 裡的文字、標題結構、內部連結、圖片替代文字和渲染結果;圖片網址抓得到,文章內容卻還在等 JavaScript 的情況,就和「方案比較」頁一樣,兩件事要分開記。
網站放在 Cloudflare 上,怎麼知道有沒有擋 AI 爬蟲?
先看 Cloudflare 的 AI Crawl Control(以前叫 AI Audit),它會列出哪些 AI 服務來抓過你的網站,也可以針對個別爬蟲設定放行或封鎖,所有方案都能用。接著再到防火牆的安全性事件紀錄裡用爬蟲名字篩選,看有沒有被擋下的請求、是哪一條規則擋的。另外,Cloudflare 公告舊的「Block AI bots」開關在 2026 年 9 月 15 日停用,現在改用 AI bot policies,依搜尋、agent(替使用者操作網站的 AI 工具)、訓練三種用途分別設定。
要不要讓 GPTBot 進來?
先分清楚你在意的是哪一件事。OpenAI 的爬蟲說明寫到,OAI-SearchBot 負責讓網站出現在 ChatGPT 的搜尋功能裡,GPTBot 則是蒐集可能用來訓練模型的內容,兩者的設定互相獨立,各自決定要不要放行。所以如果你想被 ChatGPT 搜尋引用、又不想提供訓練資料,可以放行 OAI-SearchBot、擋 GPTBot。robots.txt 的實際寫法在 OAI-SearchBot 與 GPTBot 怎麼分開設定。