
我們自己的網站 ethorx.com 根目錄也放了一份 llms.txt,你直接打開就看得到:最上面是公司名稱和一段簡介,接著是產品與服務、GEO 知識、公司這幾組連結,後面再列出所有已經發布的文章。如果你也是因為聽說「AI 會讀 llms.txt」才想做一份,那你最想知道的,大概就是哪些 AI 真的會去讀它,以及放了之後 ChatGPT 或 Google 會不會比較常引用你。整篇我會一直拿 ethorx.com 這份檔案當例子。
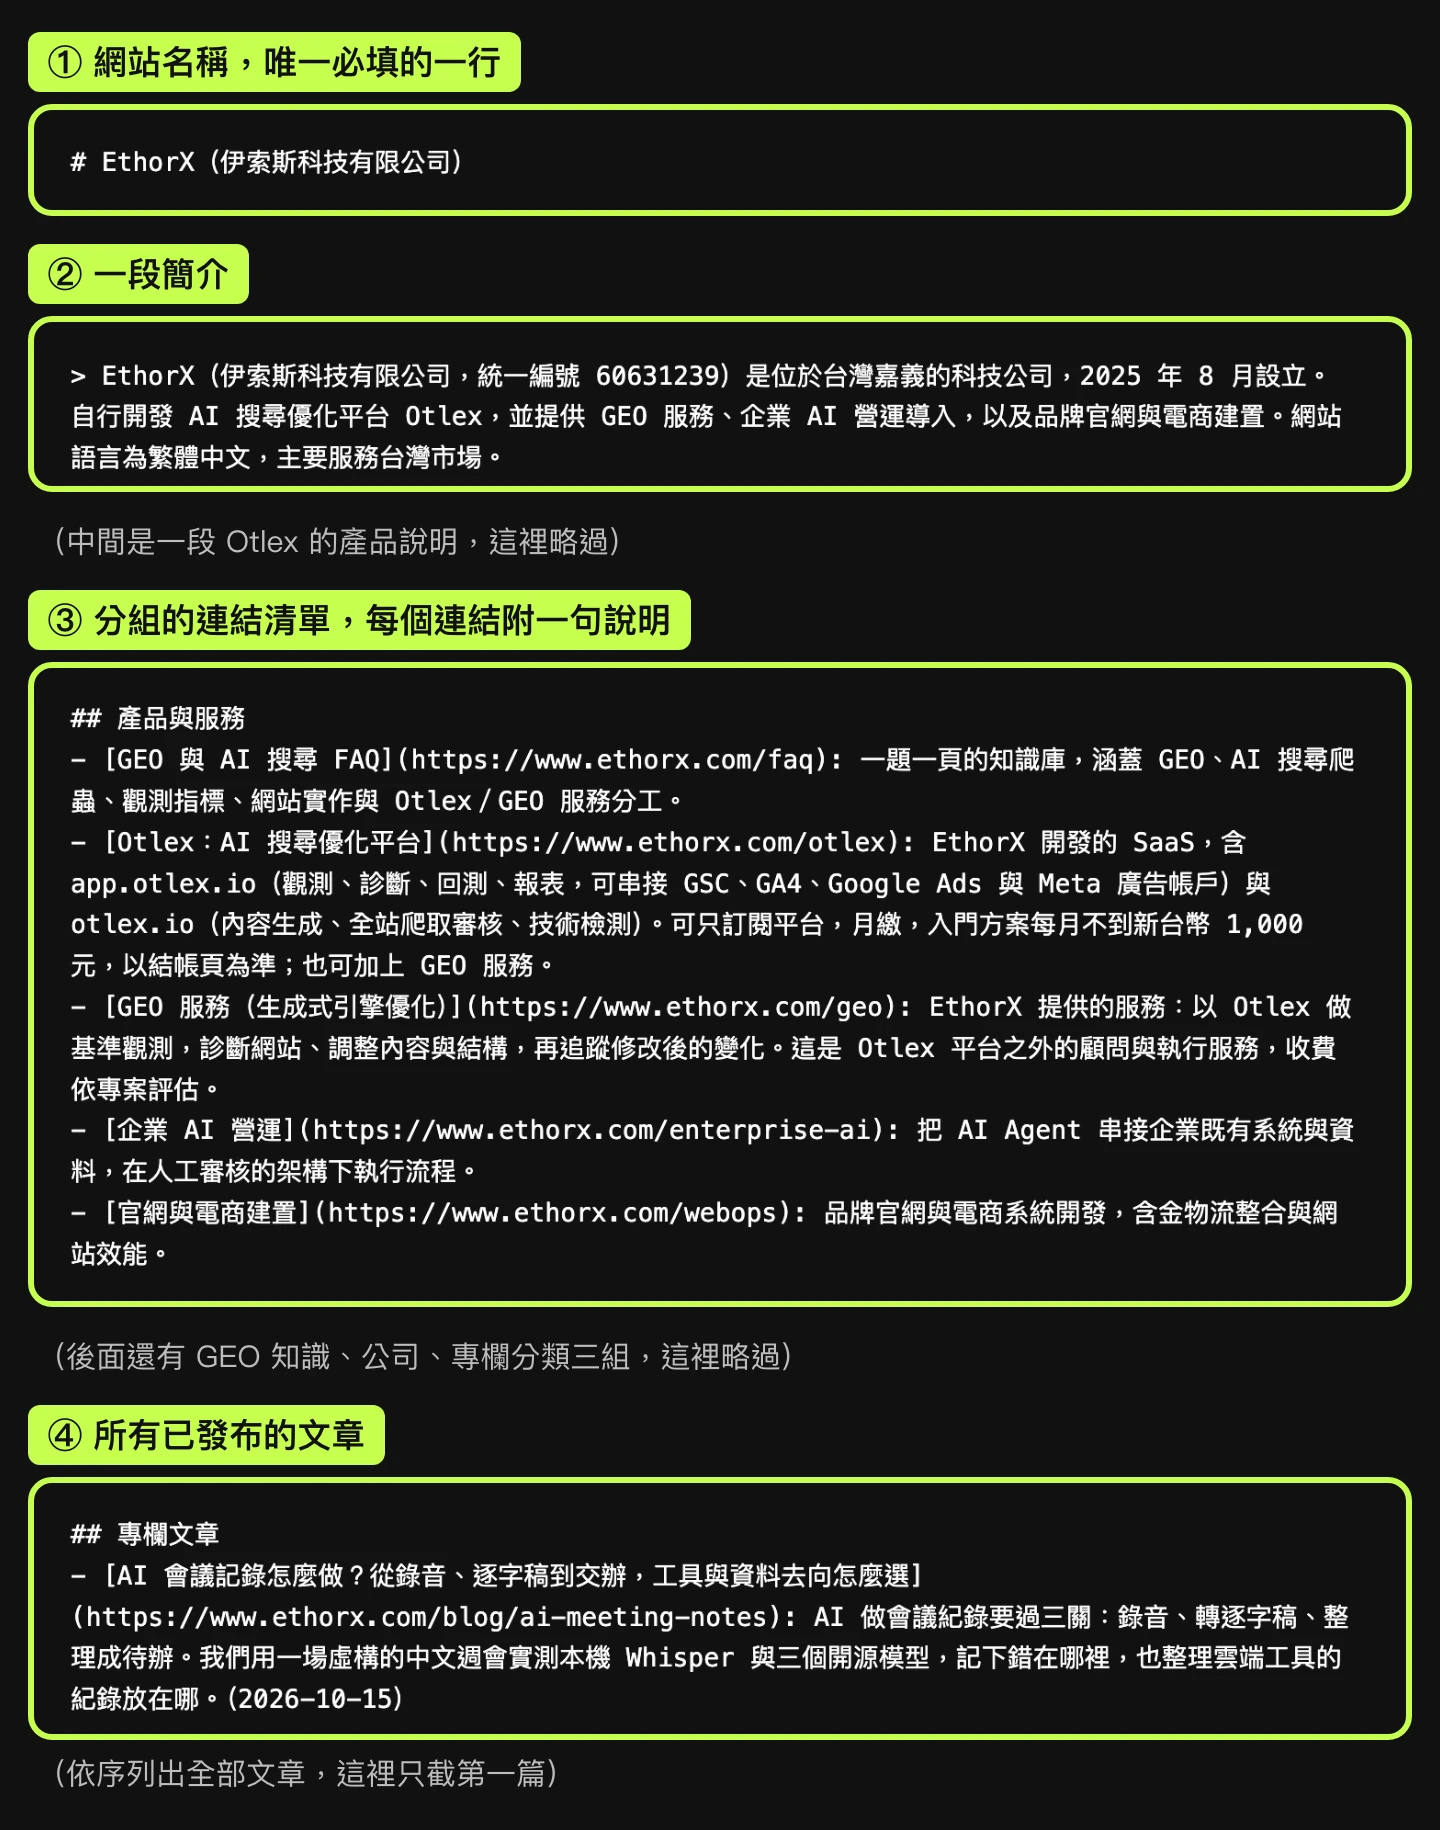 10 月 17 日打開 ethorx.com/llms.txt 看到的內容。整份檔案就是一份 Markdown:網站名稱、一段簡介,再加上幾組附說明的連結。
llms.txt 就像大樓大廳的樓層導覽牌
- 導覽牌寫的是「一樓服務台、三樓會議室」:llms.txt 列的是網站上哪幾頁重要、每一頁在講什麼。
- 門口的「員工專用」告示:robots.txt 告訴守規矩的爬蟲哪些路徑不要進去,但它是告示、不是鎖,導覽牌也管不到這件事。
- 交給搜尋引擎的完整房號清單:sitemap 列出網站所有要讓搜尋引擎知道的網址,導覽牌只挑重點。
- 牌子寫錯了,訪客就會走錯樓層:產品頁改了、llms.txt 沒跟著改,讀它的工具就會拿到過期的說明。
導覽牌只指方向,哪一層能進,要看告示和門鎖,所以 llms.txt 提供的是方向,不是權限。這個比喻不成立的地方是:大樓的訪客一定會看到導覽牌,而 AI 爬蟲會不會去讀 llms.txt,目前各家都沒有公開承諾。
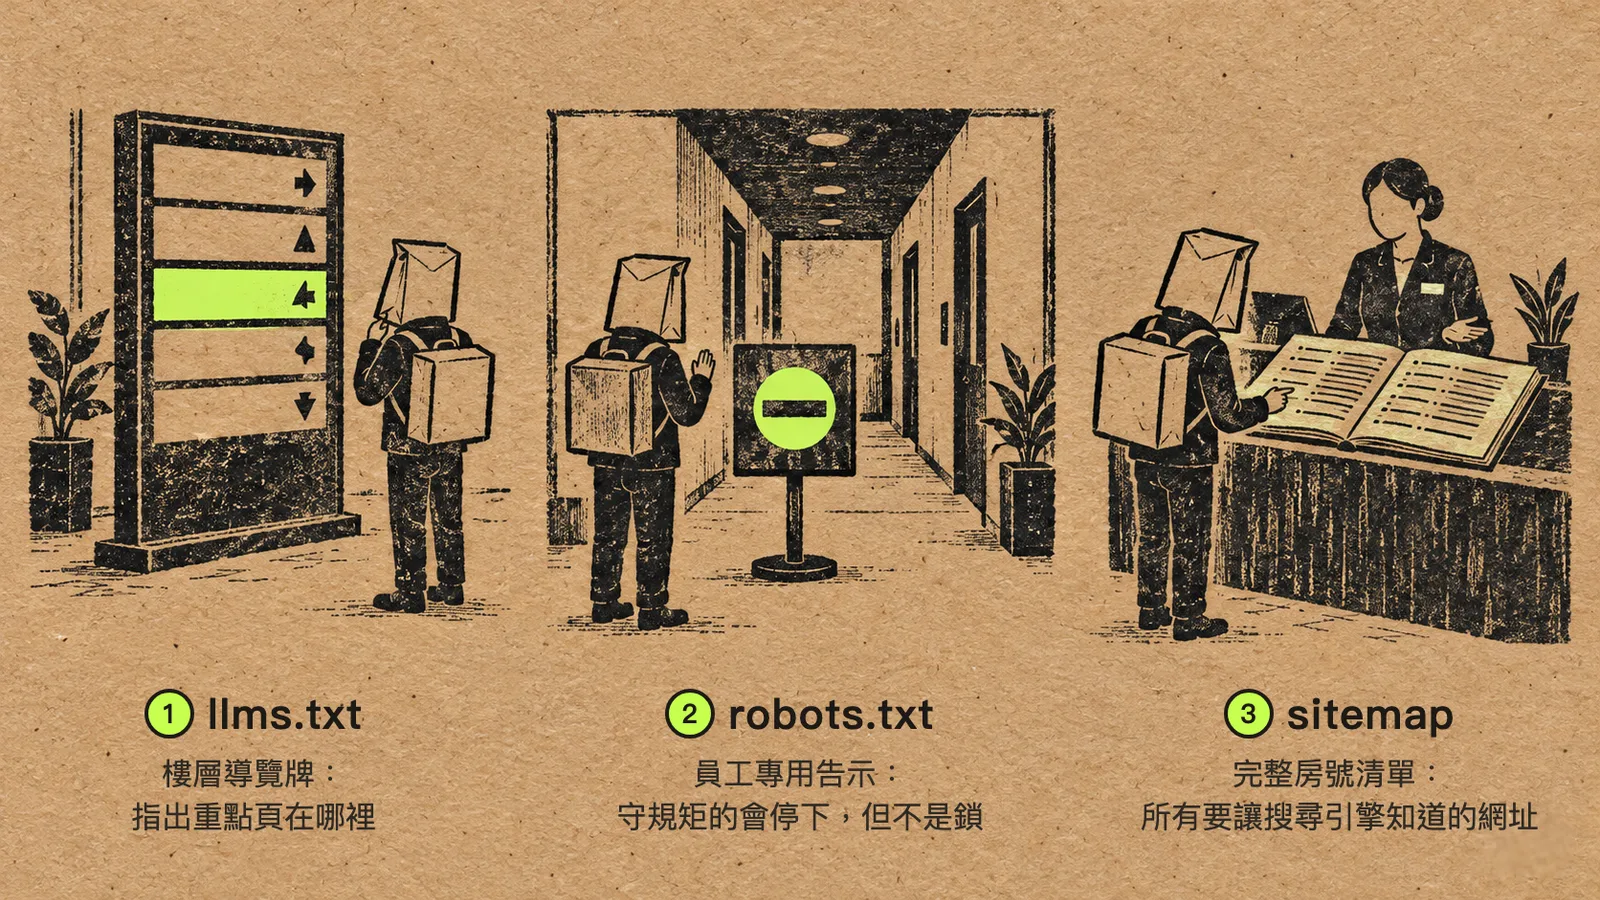 同一個大廳裡的三樣東西:導覽牌指出重點在哪,告示請守規矩的訪客別進去,櫃台的清單才列出全部房號。
robots 和 sitemap 各自怎麼設定,可以看 robots.txt 管理 AI 爬蟲和 sitemap 與 AI 爬蟲這兩篇。
llms.txt 到底處理哪一個問題
llms.txt 這個格式來自 llmstxt.org 的提案,提案人是 Jeremy Howard,2024 年 9 月提出。它的設計,是在網站根目錄放一份 Markdown 文件(一種用 #、- 這類符號標出標題和清單的純文字格式):唯一必填的是第一行的網站名稱,接著通常是一段簡短說明,再加上幾組附描述的連結清單;現在的版本也允許把它放在子目錄,例如 /docs/llms.txt 只管那個目錄底下的文件。而提案作者原本的設想,是讓 AI 在幫使用者回答問題的當下,可以很快知道這個網站該先讀哪幾頁。
所以 llms.txt 處理的是「該先看哪幾頁」這個導覽問題,頁面本身抓不抓得到、會不會被收錄,它完全沒有處理。拿 ethorx.com 來說,把 /otlex 列進 llms.txt,只是在導覽牌上寫了「產品頁在這裡」;那一頁有沒有正常回應、canonical(寫在頁面裡、告訴搜尋引擎哪個網址才是正式版本的標記)指向哪裡、robots.txt 有沒有擋、內容有沒有寫清楚,都還是要各自檢查。這和 Google 對 sitemap 的說法是一樣的,網址列進清單,不代表它已經被收錄。
先分清楚提案、標準與官方支援
llmstxt.org 自己就把它稱作提案(proposal),所以它目前是一份網站可以選擇採用的格式,還不是各家 AI 都承諾支援的標準。那各家實際怎麼說?我把 Google 和三家 AI 公司公開的說明整理成下面這張表:
| 對象 | 公開文件怎麼寫 | 對你的意思 |
|---|---|---|
| 格式本身 | llmstxt.org 稱它為提案,提供格式說明和範例 | 照提案的格式寫就可以 |
| Google 搜尋 | 生成式 AI 搜尋指南寫明 Google 搜尋不使用 llms.txt,放了不會提升也不會降低能見度或排名 | 想靠它改善 Google 搜尋或 AI 摘要,不用做 |
| OpenAI | 爬蟲說明列出 OAI-SearchBot、GPTBot、ChatGPT-User 的用途,沒有提到會讀網站的 llms.txt | ChatGPT 搜尋會不會引用你,先看 OAI-SearchBot 抓不抓得到頁面 |
| Anthropic | 爬蟲說明列出 ClaudeBot、Claude-User、Claude-SearchBot 的用途,沒有提到 llms.txt | 先處理 robots.txt 和頁面本身 |
| Perplexity | 爬蟲說明列出 PerplexityBot、Perplexity-User 的用途,沒有提到會讀網站的 llms.txt | 先處理 robots.txt 和頁面本身 |
到目前為止,這幾家都沒有公開說它們的爬蟲會讀你網站的 llms.txt,Google 更是直接寫明不使用。Google 這段說法是 2026 年 6 月 15 日加進指南的,Google 的文件更新紀錄也記下了這次澄清;而指南同時也說,如果你是為了其他會用到這類檔案的服務去維護它,完全沒有問題,只是對 Google 搜尋沒有影響。
比較有意思的是,OpenAI、Anthropic 和 Perplexity 自己的開發者文件網站都放了 llms.txt(例如 OpenAI 和 Anthropic 的這兩份),OpenAI 和 Perplexity 的爬蟲說明頁上甚至直接寫著完整的文件索引在 llms.txt(Perplexity 的原文是「Fetch the complete documentation index at: /llms.txt」)。所以我的理解是,這個格式目前比較常用在技術文件上,讓開發者和他們手上的 AI 工具更快找到該讀的文件;至於這些公司的爬蟲會不會回頭去讀你網站的 llms.txt,它們的公開文件都沒有寫。
llms.txt 與 robots.txt、sitemap 的分工
這三個檔案很容易被混在一起寫,但它們回答的是不同的問題:
| 工具 | 主要問題 | 適合放什麼 | 它管不到的事 |
|---|---|---|---|
robots.txt | 特定爬蟲可不可以請求這個網址 | 爬蟲規則與 sitemap 位置 | 頁面會不會出現在搜尋結果;收錄要另外查 |
sitemap.xml | 網站有哪些網址要讓搜尋引擎知道 | 網址、可選的更新欄位與 sitemap index | 證明抓取、索引或 AI 引用 |
llms.txt | 哪些公開文件值得先讀,怎麼快速找到 | 人和工具都能讀的頁面導覽與描述 | 它擋不了爬蟲,也不能代替頁面本身 |
例如 ethorx.com 的 robots.txt,只寫了允許所有爬蟲、擋掉 /api/ 這類不該被抓的路徑,再附上 sitemap 的位置;sitemap.xml 列出所有要讓 Google 知道的網址;而 llms.txt 則是挑出幾組重要的頁面,每一頁補一句說明。
依 Google 的 robots.txt 介紹,robots.txt 主要是用來管理爬蟲的流量,它擋不住頁面出現在搜尋結果裡,被擋的網址還是可能被列出來,只是沒有描述;要讓頁面不出現在 Google,得用 noindex 或密碼保護。而依 sitemap 文件,sitemap 能幫 Google 更有效率地找到和檢索網址,但不保證清單裡的每個網址都會被檢索和收錄。所以這三個檔案雖然都放在根目錄,但不要拿其中一個去替另一個做事。
什麼情況值得維護
要不要建 llms.txt,我會看維護成本和內容管理上的需求,我的判斷方式是先問一個門檻問題,再問三個加分的問題,下面順便附上 ethorx.com 自己的答案:
- 門檻:改版時有沒有人會同步更新它?沒有的話就先不要做,因為一份過期的導覽牌,可能比沒有導覽牌更容易讓人走錯。ethorx.com 的文章清單是建置時自動產生的(做法在下面),所以這一題我們答得出來。
- 有沒有一組穩定、公開、希望被人快速找到的核心頁面?ethorx.com 有:Otlex、GEO 服務和公司介紹這幾頁。
- 每一條都對得回真正的頁面嗎?ethorx.com 的每一條都是站內已經公開的網址,描述也直接取自那一頁。
- 能不能接受它對 Google 搜尋沒有作用?我們能接受,因為我們做它本來就不是為了 Google 排名。
過不了門檻的話,就先改善公開頁面的內容、內部連結、robots.txt 和 sitemap,那些更直接。
如果過了門檻,就可以把它放進內容的發布清單:每次刪頁、改網址、產品功能改了或換了內容負責人時,順便檢查裡面的連結還能不能用。要避免的是不同團隊各自維護,最後變成一份跟正式頁面說法對不上的第二份內容。
我們的做法是讓 llms.txt 在網站建置時自動產生:開頭的公司簡介、產品與服務、公司這幾段是手寫的,文章清單則直接從已發布的文章帶出標題、摘要和日期。所以新增或刪掉文章時不用去改它,但產品的描述一旦改了,就要記得回頭改那幾段手寫的文字。
一份可維護的內容結構
下面是依公開提案整理的最小範例,內容參考 ethorx.com 那份檔案縮短:
# EthorX

> EthorX 是台灣的科技公司,開發 AI 搜尋優化平台 Otlex,並提供 GEO 服務。

## 產品與服務

- [Otlex](https://www.ethorx.com/otlex): EthorX 開發的 AI 搜尋優化平台,產品能力以這一頁的最新內容為準。
- [GEO 服務](https://www.ethorx.com/geo): 說明服務內容、進行方式,以及 Otlex 平台和顧問服務怎麼分工。

## 文章

- [AI 能見度](https://www.ethorx.com/blog/ai-visibility): 說明怎麼衡量提及、引用與推薦,以及限制。

## Optional

- [隱私權政策](https://www.ethorx.com/privacy)
這個範例有四個維護重點。第一,連結都指向公開的頁面,不在檔案裡複製一段可能會過期的產品承諾。第二,每一條描述只講那一頁真的寫了什麼。第三,正式網址還是由網站的路由和 canonical 決定,llms.txt 只是照著列。第四,產品功能要對照正式的公司資訊和產品頁,就算是為了讓 AI 更好理解,還沒確認的功能也不放。最後那段 Optional 是提案裡的慣例,放的是次要的連結,讀它的工具如果不需要那麼多內容,可以直接跳過這一段。
另外,不要在 llms.txt 放 API key、沒公開的客戶資料、內部後台網址、還沒確認的案例數字,或只寫給爬蟲看的祕密提示。因為這份檔案和一般公開網頁一樣,任何人都打得開,所以裡面連到的內容,都要先確認可以公開。
建立後怎麼檢查
檢查的目標,是確認這份公開文件讀得到、內容還是正確的;某個 AI 有沒有用它,要另外查。我會照這個順序記錄:
- 用 HTTPS 直接請求
/llms.txt,保存檢查日期、HTTP 狀態和內容版本。 - 檢查每個連結是否指向預期的公開頁面,並記錄 200、重新導向、404 或需要登入的狀態。
- 逐頁核對 title、canonical、頁面上的重點說法和看得到的內容,不要只看
llms.txt的描述。 - 檢查 robots.txt、sitemap 和內部連結,是否仍和頁面的實際狀態一致。
- 想知道某家 AI 有沒有來讀,最直接的是看伺服器紀錄(log)裡有沒有那家爬蟲請求過
/llms.txt;這段期間沒看到請求,也只能說這段期間沒看到,不能推論它永遠不會讀。 - 如果網站有版本控制,每次修改都記下原因和改了哪些連結,之後才查得到某個連結是什麼時候拿掉的。
例如 10 月 20 日檢查 ethorx.com 的 /llms.txt:第 1 步拿到 200、格式是 text/plain;裡面列了 118 個連結,所以第 2 步我會用程式批次檢查,不會一個一個點。檔案打得開,和 AI 真的讀過,是兩件要分開確認的事。在拿到伺服器紀錄、官方說明或能重複的測試結果之前,你能確定的只有「這份文件已經公開」。
常見問題
llms.txt 會提升 Google AI Overviews 的出現機率嗎?
不會。Google 的生成式 AI 搜尋指南寫明 Google 搜尋不使用 llms.txt,放了不會提升也不會降低曝光或排名。AI 摘要看的仍然是頁面能不能被檢索、收錄,以及符不符合顯示摘要的資格這些原本的條件。
llms.txt 可以取代 robots.txt 嗎?
不行。robots.txt 是爬蟲存取規則的一部分,llms.txt 只是內容導覽的提案。回到樓層導覽牌那個比喻:把牌子上的三樓擦掉,三樓的門還是開著的。要限制 Google 爬蟲存取,就依 Google 的 robots 文件、noindex 或權限控制來選方法。
llms.txt 可以列出尚未公開的文件嗎?
根目錄的檔案本身就是公開的,任何人都打得開。如果在裡面連到未公開、需要登入或含敏感資訊的內容,等於在公開的牌子上寫出那扇門在哪裡。某一頁不該公開的話,要先處理權限和公開狀態。
我應該把所有文章都放進 llms.txt 嗎?
看你的 llms.txt 是手寫還是自動產生。手寫的話,我建議只列讀者理解網站主題需要的核心頁面,因為把整份 sitemap 複製進去,每次增刪文章都要跟著改,導覽效果卻沒有變好。像 ethorx.com 是建置時自動從已發布的文章帶出清單,全部列進去不會多出維護工作,這時候列全部也沒問題;但開頭那幾組手寫的核心頁,還是要有人定期看。
沒有 llms.txt 就不能做 AI 搜尋優化嗎?
不會,照樣可以做。Google 目前不把 llms.txt 當成 Google 搜尋的加分或扣分條件,所以就 Google 搜尋來說,沒有它並沒有少掉什麼。AI 搜尋的內容管理,從公開頁面、內部連結、抓得到的文字、來源標示、結構化資料,以及用固定題目留下的查詢紀錄開始就好,各平台的實際行為再分別確認。
把 llms.txt 放回日常的內容管理
如果要採用 llms.txt,我會把它當成一個小型、隨時可以撤回的嘗試:先決定由誰來更新,記下每次檢查的日期和連結狀態,再看維護成本合不合理。真正要小心的是它的副作用:一份看起來很完整的導覽檔,容易讓團隊覺得「AI 那邊處理好了」,而頁面本身的檢索、收錄和 canonical 問題卻還原封不動地留在那裡。
回到開場那兩個問題。哪些 AI 會去讀 llms.txt,各家的公開文件都沒有寫;放了之後會不會比較常被引用,Google 已經寫明它的搜尋不會因此加分,其他家則沒有任何說明。我們還是留著 ethorx.com 那一份,是因為它在建置時自動產生,幾乎不花維護時間,而開發者手上的 AI 工具也可能用得到它;但 AI 回答有沒有引用我們,我們還是看頁面本身和實際的回答紀錄,不會看這份檔案。
參考來源
以下依各家官方文件整理,Google 對 llms.txt 的說法與各家爬蟲的支援範圍以官方頁面當下為準。
- Google’s Guide to Optimizing for Generative AI Features on Google Search,Google Search Central。
- Latest Google Search documentation updates,Google Search Central。
- Introduction to robots.txt,Google Search Central。
- Learn about sitemaps,Google Search Central。
- The /llms.txt file,llmstxt.org 提案。
- Overview of OpenAI Crawlers,OpenAI。
- Does Anthropic crawl data from the web, and how can site owners block the crawler?,Anthropic。
- Perplexity Crawlers,Perplexity。