
你在一家做工業烤箱的設備商當業務,B 客戶來電問:「我們的付款條件是月結幾天?」你在公司內部的 AI 助理裡打了同一個問題(這個助理當時還沒接上公司的合約庫,只靠模型自己回答),幾秒後得到一句很乾脆的回答:「月結 60 天,依 2025 年簽訂的合約第 4 條。」語氣篤定,還附了條號,你就照這個條件回覆了客戶。月底財務來找你,因為合約第 3 條寫的是月結 30 天,而第 4 條講的其實是交貨地點;客戶已經照 60 天排了付款,這筆貨款要晚一個月才進來。
這就是一般說的 AI 幻覺。它麻煩的地方在於,錯的答案看起來和正確答案一模一樣:句子通順、格式完整,連條號都有。句子寫得通順,不代表內容是對的,而且模型寫得越像真的,人就越容易省掉核對那一步。這篇會一直拿這個付款條件的例子,說明幻覺從哪裡來、企業可以在哪幾步把它擋下來。
AI 幻覺是什麼:講得很有把握,內容卻是錯的
AI 幻覺(hallucination)指的是 AI 模型產出錯誤或誤導性的內容,而且通常用很有把握的語氣呈現。美國國家標準暨技術研究院(NIST)的生成式 AI 風險框架把這種現象叫做 confabulation(虛構),意思是生成式 AI「自信地產出錯誤或虛假的內容」,並註明一般俗稱「幻覺」或「捏造」。NIST AI 600-1
而且 NIST 劃的範圍比「說錯事實」更寬,還包括兩種情況:回答偏離了你給的提示詞(你打給 AI 的指示)或文件,以及和同一段對話裡自己先前的說法互相矛盾。另外,模型也可能捏造連結,指向根本不存在的網頁。Google Cloud:什麼是 AI 幻覺?
OpenAI 研究團隊在 2025 年 9 月發表的論文〈Why Language Models Hallucinate〉,開頭就拿作者之一 Kalai 自己當例子。他們問一個開源模型:「Adam Tauman Kalai 的生日是哪天?知道的話只回答日-月。」模型試了三次,給了三個不同的日期,三次都錯,雖然題目明明說了「知道的話」才回答。接著再問三個熱門模型他的博士論文題目,三個模型都沒開網路搜尋,都答出了一個像樣的題目、學校和年份,也都不對(Kalai 等人(2025))。
這個例子說明了幻覺最麻煩的地方:模型給不出正確答案時,它很少留白,通常會產出一個格式正確、看起來合理的錯誤答案。
為什麼會發生:模型在猜下一個字,評分又獎勵猜
要理解幻覺,要先知道大型語言模型在做什麼。LLM 實際在做的事,是照著訓練資料裡文字出現的規律,一直預測句子裡的下一個 token(模型處理文字的最小單位)。這種預測多數時候能寫出正確、一致的內容,但同一套機制,也會寫出事實錯誤或前後矛盾的內容(NIST AI 600-1)。LLM 的運作細節,我在 LLM 是什麼另外整理過了。
可以把模型想成一個考試時不會也要寫滿的學生。
OpenAI 那篇論文自己就用考試來比喻,這個比喻剛好能對上幻覺的兩個成因和一個症狀:
- 沒讀過的題目:課本只提過一次的冷門題,學生本來就記不住。模型也一樣,B 客戶的合約它從來沒看過。
- 空白一定零分,亂寫可能有分:如果計分方式讓「猜一個答案」比「寫不知道」划算,學生就會學會每題都寫,模型也是這樣被訓練出來的。
- 字寫得工整,不代表答對:學生會把猜的答案寫得很像樣,模型也會把「月結 60 天、第 4 條」寫得很篤定。
比喻對不上的地方是:學生多半知道自己在猜,模型卻不一定分得出自己是「知道」還是「猜的」,所以你沒辦法只靠問它「你確定嗎」來抓錯。
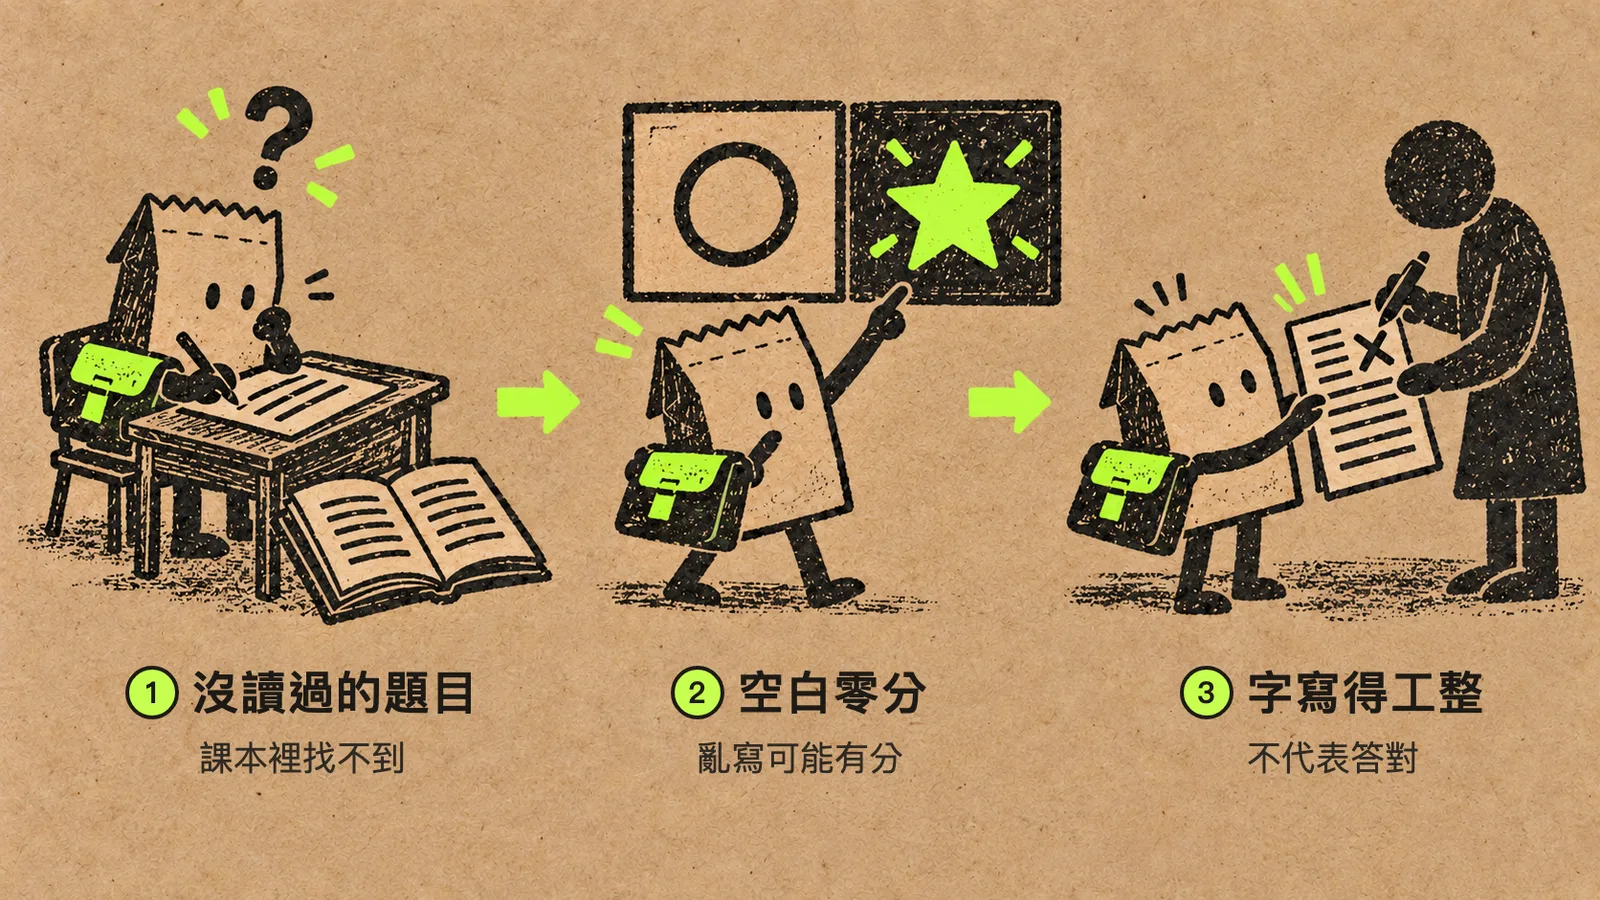 幻覺不是模型在說謊,而是它被訓練成「不會也要寫」,而且寫得很像樣。
OpenAI 那篇論文,把原因拆成模型訓練的兩個階段來看,剛好對上比喻的前兩點。
第一階段,讀大量文字學語言:只出現過一次的事實最容易錯
模型的第一階段訓練(業界叫預訓練),是從大量文字裡學語言。愛因斯坦的生日在網路上出現過無數次,所以模型很少答錯;但一般人的生日,可能只在某篇訃聞裡出現過一次,沒有第二個來源可以對照,模型就沒有規律可以依循。論文的推算是:如果訓練資料裡有 20% 的生日資訊只出現過一次,那只經過這個階段的模型,在生日這類問題上預期至少會有 20% 答錯。
換到你的情境,B 客戶的合約條件、烤箱的最新規格、上個月才改的價格,這些資訊模型要嘛沒看過,要嘛只看過一次。所以你直接問它 B 客戶的付款條件,本來就是在問一件它不可能知道的事,就像考一題課本沒教的題目。
第二階段,調整與評分:猜一個答案比說不知道划算
模型訓練完之後,還會再經過一輪調整,其中一個目標就是減少幻覺。那為什麼幻覺還是一直出現?論文的解釋是,語言模型的評測大多只算答對率:答對得分,答錯和回答「不知道」都是零分。在這種計分方式下,一直猜的模型分數反而比較高,所以模型就被訓練成一直處在「考試模式」,不會的題目也照樣作答,也就是比喻裡那個不會也要寫滿的學生。
因此作者建議,與其另外設計新的幻覺測驗,不如修改主流評測的計分方式,例如在題目裡寫明「有 75% 以上把握才作答,答錯會扣分」,讓模型承認不確定時不再吃虧。
公司導入時:沒給它依據,或給錯了依據
前兩段講的是模型本身。而實際導入時,還有兩個常見原因是出在系統設計上:
- 沒有提供依據。Google Cloud 把「缺乏適當的依據」列為幻覺的主要原因之一。模型沒拿到 B 客戶的合約,就只能用它學過的一般慣例去補。
- 提供了錯的依據。做了 RAG(檢索增強生成)之後,模型會先查文件再回答,但 AI 去文件庫查資料時,可能找到舊版規格,或抓到另一個客戶的合約。模型照著錯的段落回答,看起來一樣言之有據。
幻覺常見的幾種樣子
把幻覺分類,是為了知道該在哪一步把它擋下來。以下是企業情境裡最常見的幾種:
| 類型 | 企業裡的例子 | 最容易出現在 | 先從哪裡擋 |
|---|---|---|---|
| 編造事實 | 問某客戶的付款條件,答出合約裡沒有的天數 | 模型沒看過的內部資訊、少見的專有名詞 | 提供文件當作依據,找不到就回答找不到 |
| 編造出處 | 附上不存在的條號、判例、論文或網址 | 要求它「附上來源」,卻沒給它資料時 | 出處必須能點回原文,逐條核對 |
| 違背提供的文件 | 文件寫 30 天,回答寫 60 天 | 文件很長、段落相似、版本很多 | 先請它摘出原文再回答;讓 AI 查的文件庫只放現行版本 |
| 前後矛盾 | 先答 B 客戶月結 60 天,追問一句又改口說 45 天 | 長對話、多輪追問 | 同一題多問幾次比對;重要數字直接到 ERP 查 |
| 虛構的推理過程 | 算式步驟寫得很完整,結果卻是錯的 | 計算、比較、推論型的問題 | 數字交給系統或試算表算,模型只負責說明 |
編得最像的往往是出處。NIST 特別提到,生成式 AI 可能會附上虛構的推理或引用,來替自己的答案背書,讓人更容易誤信。一句沒有來源的話,讀的人多少會懷疑;但一句附了條號、判決字號的話,大家通常就直接拿去用了,就像開場那句「依合約第 4 條」。
兩個真實案例:錯了之後,責任在誰
幻覺造成的損失,最後都會回到使用它的人或公司身上。下面這兩個判決,常被拿來說明這件事。
第一個是 2023 年美國紐約南區聯邦地方法院的 Mata v. Avianca 案。原告律師用 ChatGPT 找判例,結果提交給法院的書狀裡,引用了根本不存在的判決,連判決內容與引文都是生成出來的。律師事後說,他當時沒想過 ChatGPT 會捏造案例。法院在 2023 年 6 月 22 日的裁定中,罰兩位律師與所屬事務所共 5,000 美元。
第二個是 2024 年加拿大卑詩省民事糾紛仲裁庭的 Moffatt v. Air Canada 案。一位旅客在航空公司官網上,問客服聊天機器人喪親優惠票價的規定,機器人說可以先買票、事後再申請退差價;但官網另一頁寫的規定正好相反。航空公司主張,聊天機器人應該被視為獨立的主體,所以公司不必為它的說法負責。仲裁庭不接受這個說法,認為資訊來自靜態網頁還是聊天機器人,對公司來說都一樣,最後判航空公司要賠償。
這兩個案子的共同點很清楚:模型答錯時,責任落在使用它的公司身上。律師要為書狀負責,航空公司要為官網上的每一句話負責,包括聊天機器人說的話。既然責任在公司身上,企業就要先決定,AI 寫的哪些內容可以直接給客戶看,哪些一定要先經過人確認。
企業導入時,降低幻覺的五個做法
幻覺沒辦法歸零,所以你要設計的是:答錯的時候,會被誰、在哪一步攔下來。以下五個做法是照導入順序排的,前幾個的成本比較低,我會建議一開始就做,各項成本整理在後面的表。
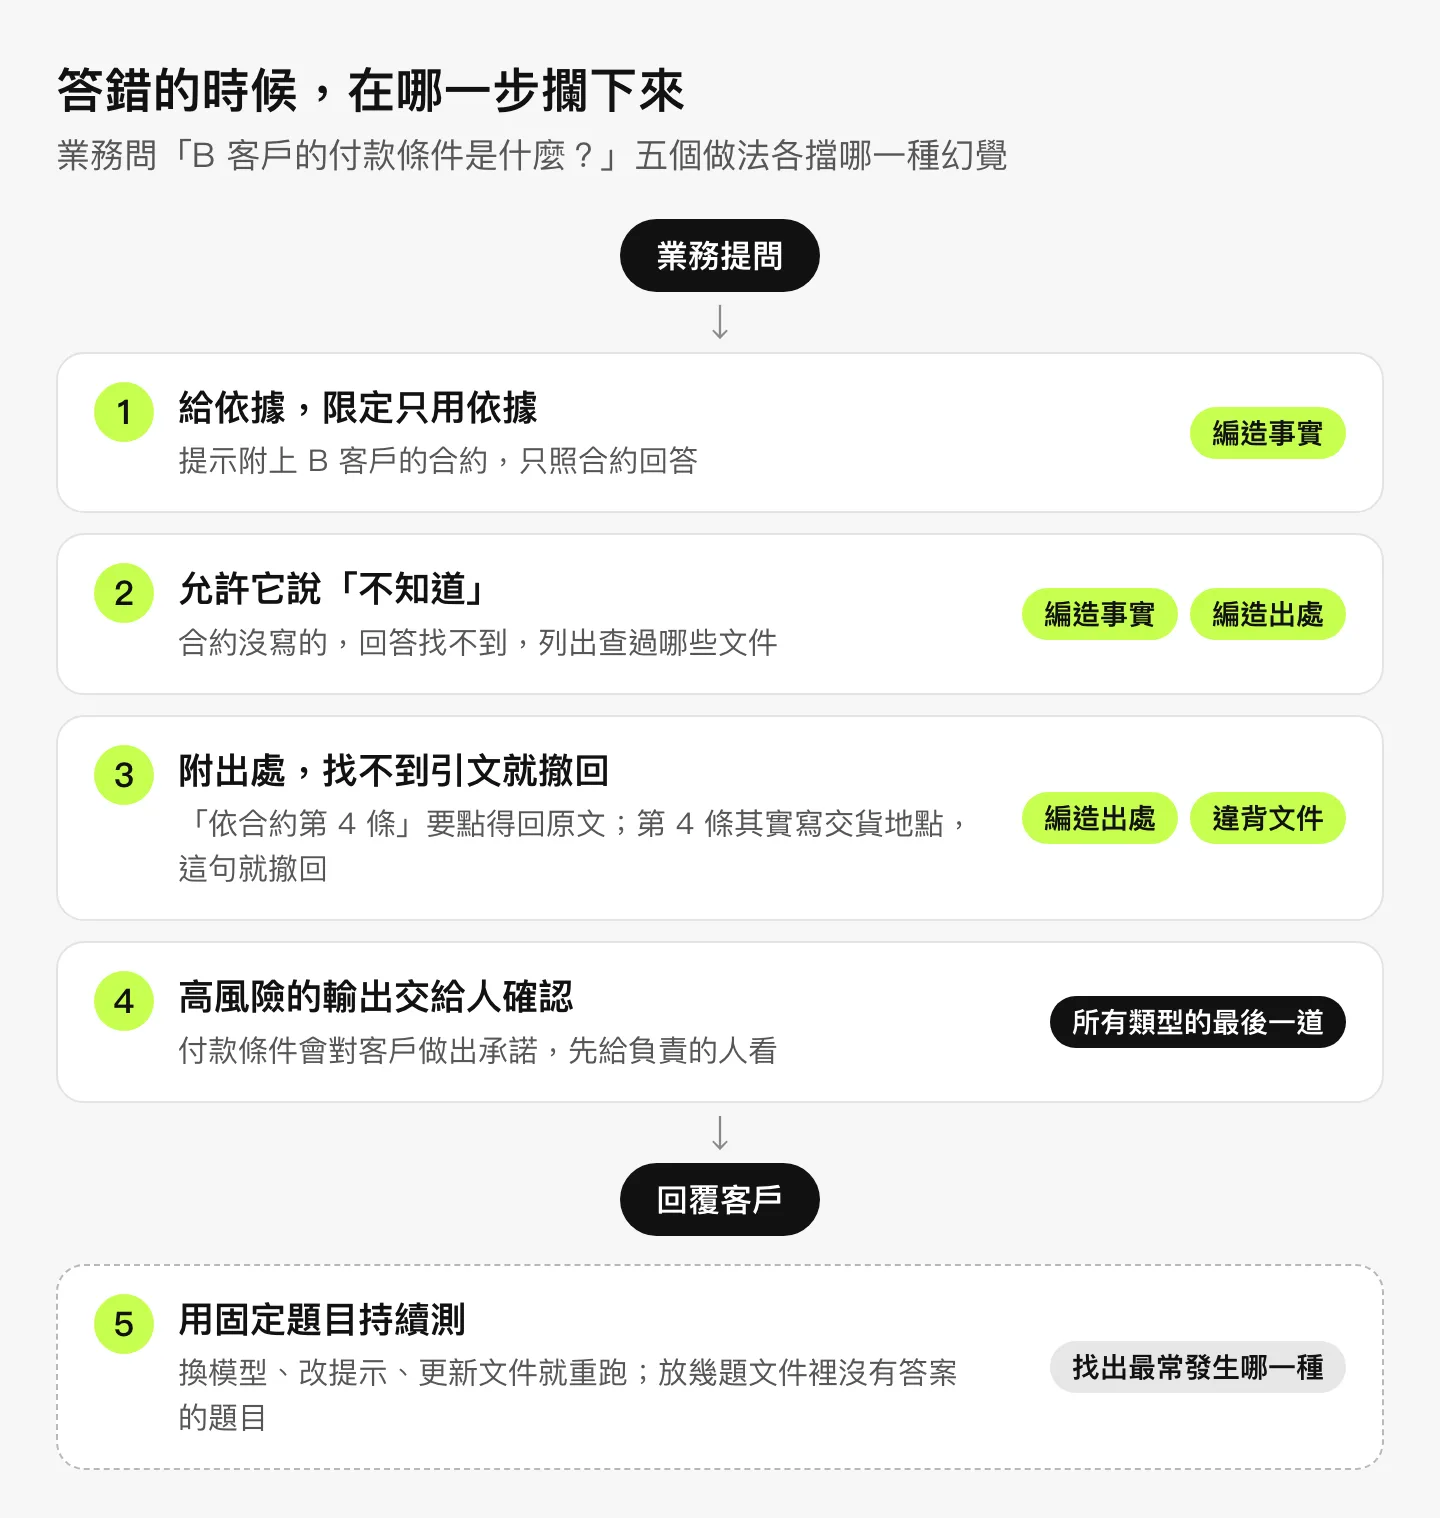 用開頭付款條件的例子來看,前三道在模型作答時就把錯擋掉,第四道在回覆客戶前由人確認;第五個做法不在流程裡,是定期回頭測,看哪一種錯最常出現。
1. 給它依據,並限定只用這些依據
內部問答最有效的一步,是讓模型依照你提供的文件回答,也就是用 RAG,或直接把文件放進提示詞裡。Anthropic 的建議更進一步:明確要求模型只使用你提供的文件,不要拿它自己的一般知識來補。Anthropic:Reduce hallucinations
回到付款條件的例子,提示裡應該寫的是「只依以下合約內容回答;合約沒有寫的,就回答找不到」,這會比單純問「B 客戶的付款條件是什麼」可靠得多。資料要整理到什麼程度,可以看企業知識庫要整理到什麼程度,AI agent 才用得上。
2. 允許它說「不知道」
這一步看起來很簡單,效果卻常被低估。Anthropic 的文件把「明確允許模型承認不確定」列為第一個基本做法,並說這個簡單的技巧就能大幅減少錯誤資訊。對照前面講的評分方式,這等於是在規則裡告訴它:答不出來可以不答,不會被扣分。
實務上,你可以寫成「如果文件裡找不到答案,請回答『文件中沒有這項資訊』,並列出你查過哪些文件」。後半句很有用,因為使用者能因此知道,是文件裡真的沒有,還是它沒查到該查的那份文件。要給團隊重複使用的提示詞怎麼寫成完整的規格,可以看提示詞怎麼寫。
3. 要求附出處,找不到引文就撤回
要求每個主張都附上出處,答案才有辦法被核對。Anthropic 建議的做法分成兩步:處理長文件時,先請模型逐字抽出相關的引文,再根據這些引文作答;答完之後,再請它替每一句話找出支持的引文,找不到引文的那句話就撤回。
而出處要能點回原文。只寫「根據公司規定」的出處沒有用;要寫成「2026 年 3 月版報價規則第 2 節」,人才有辦法打開來確認。
4. 高風險的輸出交給人確認
哪些輸出要先經過人看才能放出去,要依影響來決定:會對客戶做出承諾的(價格、交期、合約條件、退款規則)、會寫進訂單、客戶資料等公司系統的,以及涉及法律或安全的,都應該先暫停,交給負責的人確認。開場那句「月結 60 天」就屬於這一類。
不過確認點要設得少而準。如果每一筆都要人看,最後大家就會跳過不看。要怎麼分級,可以看 AI agent 的權限與人工確認怎麼設。我們在企業 AI 營運方案導入時,也是在上線前和負責的主管一起列出哪些回答會對客戶做出承諾,把這些設成先暫停、由專人確認後才送出。
5. 用固定題目持續測,包含沒有答案的題目
從同事和客戶實際問過的問題裡挑二、三十個,寫好標準答案和應該引用的段落,之後每次換模型、改提示或更新文件,就重跑一次。記得放幾題文件裡沒有答案的問題:正確的行為是回答找不到,硬湊出答案就算錯,這是測幻覺最直接的方法。
如果要自動化,Microsoft Foundry 的評估工具裡有一項專門檢查「回答是不是根據你提供的資料,有沒有自己編造內容」(Groundedness)。Microsoft Learn:RAG evaluators Anthropic 也建議把同一題跑幾次、比對答案是否一致,因為不一致的地方很可能就是幻覺。完整的驗收設計,我寫在 AI agent 專案怎麼驗收。
| 做法 | 成本 | 擋住的是哪一種幻覺 |
|---|---|---|
| 給依據、限定只用依據 | 中:要整理文件、建檢索 | 編造事實 |
| 允許說不知道 | 低:改提示 | 編造事實、編造出處 |
| 附出處、找不到引文就撤回 | 低到中:改提示、多一次檢查 | 編造出處、違背文件 |
| 高風險輸出人工確認 | 中:要訂規則、排人力 | 多數類型都能攔下,是最後一道關卡 |
| 固定題目持續測 | 中:建題目、定期重跑 | 找出哪一種最常發生 |
回到 B 客戶那通電話。照前三個做法設定之後,助理會先去讀 B 客戶的合約,回答「合約第 3 條寫月結 30 天」並附上那一句原文;如果它找不到合約,就會說找不到,而不是給你一個 60 天。就算它還是答錯,付款條件屬於要先給人確認的承諾,你在回覆客戶之前就會看到原文和它對不上,那一個月的貨款也就不會晚進來。至於那次已經發生的錯,該做的是打電話向 B 客戶更正,附上合約第 3 條的原文,再把付款條件列進要先確認的承諾清單。
幻覺可以完全消除嗎
目前沒有辦法保證歸零,就算那個助理接上了 RAG 也一樣。OpenAI 的論文指出,只要訓練資料裡有模型分不出對錯的內容,預訓練就會產生錯誤;而只要主流評測仍然讓猜測比承認不確定得分更高,模型就會傾向去猜。論文也提到,最新的模型仍然有幻覺。RAG 能讓模型照著你的文件回答,減少編造事實的機會,但檢索可能抓錯文件,模型也可能在文件之外自己補一句,所以它降低的是機率,不是把幻覺歸零。
降低風險的每一層也都可能漏。例如開頭付款條件的情境,檢索可能抓到舊版合約,負責確認的人可能只看了金額、沒看天數,測試題也剛好沒有涵蓋這個客戶。所以比較務實的目標,是讓錯誤在造成損失之前被看見,而且每個答案都能追回它的來源。
用到 AI agent 時更要留意這一點。因為 agent(會自己動手執行工作的 AI 助理)會依模型的判斷去寄信、建立訂單,幻覺的代價就從「答錯一句話」變成「做錯一件事」。反過來說,資料過期、權限沒設好、流程沒人負責確認,這些問題換一個更強的模型也解決不了。
AI 搜尋把你公司講錯時:先分辨是編造還是來源寫錯
另一種情況,是發生在公司外面。例如有新客戶在 Google 搜你們公司,AI 摘要說你們「主力是桌上型烤箱」,但那個系列三年前就停產了;或是把總部寫在錯的城市,把你和同名的公司混在一起。
這類錯誤不一定是模型憑空編造的。Google 在 2024 年 5 月自己說明 AI 摘要的問題時寫到,AI 摘要和搜尋排名系統是整合在一起的,所以一般不會像其他 LLM 產品那樣「幻覺」;出錯的原因多半是誤解了查詢、誤讀了網頁上的語意,或是這個問題本來就沒有足夠好的資訊。它舉的例子是「每天該吃幾顆石頭」:網路上幾乎沒有人認真討論這個問題,唯一相關的是一篇諷刺文章,剛好又被一家地質軟體公司轉載,AI 摘要就照著引用了。Google:AI Overviews: About last week
所以我的處理順序是:先點開它引用的那一頁,看錯誤是從哪裡來的。
| 你看到的狀況 | 比較可能的原因 | 先處理哪裡 |
|---|---|---|
| 引用的頁面本身就寫錯(舊新聞、過期的目錄、同名公司) | 來源錯誤,模型照實轉述 | 修正自己的頁面;第三方頁面就聯絡對方更新 |
| 官網和第三方網站的說法不一致 | 來源互相矛盾,模型挑了其中一個 | 統一名稱、類別、服務範圍的說法 |
| 這個問題沒有任何頁面認真回答過 | 資訊空白,模型只能拼湊 | 補一頁直接回答這個問題的內容 |
| 引用的頁面寫得對,回答卻寫錯 | 模型誤讀或編造 | 向平台回報;把關鍵事實寫成一句話就看得懂的句子 |
前三種都是來源的問題,也是品牌自己能直接動手處理的部分。
AI 搜尋講錯公司時,多數要回頭修的是來源;跟模型爭論,改變不了它下一次的答案。
官網各頁的說法要怎麼統一,可以用品牌資訊一致性檢查的稽核表;引用網址怎麼記錄、怎麼判斷那一頁有沒有支持回答,可以看 AI 引用來源網址怎麼分析;而 AI 怎麼從候選來源組出答案,則寫在 AI 怎麼決定推薦哪個品牌。
第四種才是真正的模型錯誤。Google 的說明頁寫明,AI 摘要可能提供不準確的資訊,使用者可以按「回報問題」送出意見(Google 搜尋說明:關於 AI 摘要)。回報值得做,但平台不會承諾多久更正,所以你自己的頁面還是要寫清楚。
我們的 GEO 服務(讓 AI 搜尋正確介紹你公司的優化工作)處理的就是這一段:用自己開發的 AI 搜尋優化平台 Otlex,定期用同一組顧客會問的問題去問 AI,記下它怎麼描述你、引用了哪幾頁,再指出是哪一頁寫錯或沒寫。如果你已經看過不正確的 AI 回答,把截圖、問的那句話和日期一起留下來,這是之後追查來源最需要的三樣東西。
常見問題
ChatGPT 開了搜尋功能,還會有幻覺嗎?
會少一些,但還是會發生。開了搜尋之後,模型多了可以依據的網頁,編造事實的機會會降低;但它仍可能讀錯網頁、引用不相關的頁面,或在網頁內容之外自己補上一句。所以回答附的連結,重要的資訊都要點開,確認那一頁真的是這樣寫。
在提示裡寫「不要亂編」有用嗎?
有一點用,但不夠。比較有效的寫法是給出具體的規則:只依提供的文件回答、找不到時要回答哪一句話、每個主張都附上引文。Anthropic 建議的做法,都是這類可以檢查的規則。規則寫好之後,還是要用沒有答案的測試題,確認它真的會照做。
網路上看到的「幻覺率」數字,可以拿來挑模型嗎?
參考價值有限。每份測試用的題目、允不允許模型回答不知道、有沒有開搜尋都不一樣,所以數字之間沒辦法直接比較。OpenAI 的論文也指出,多數主流評測只算答對率,會把「猜對」和「真的知道」混在一起。所以挑模型時,我會建議用你自己的真實問題測一輪,這會比看排行榜可靠。
員工用 ChatGPT 寫對外文件,公司應該先訂哪些規則?
至少要有三條:
- 數字與條款由人核對:對外文件裡的數字、日期、條款和引用來源,一律由人對照原始資料確認。
- 出處要點開檢查:要求 AI 附上出處的內容,出處要實際點開看,這正是 Mata v. Avianca 案的律師漏掉的那一步。
- 哪些資料不能貼要先講清楚:客戶資料、合約內容能不能貼進哪一種 AI 工具,要事先講清楚。
AI 把我們公司講錯了,可以直接請平台更正嗎?
可以回報,但沒有保證會更正的管道。以 Google 的 AI 摘要為例,你可以按「回報問題」送出意見。比較可靠的做法是同時處理來源:把正確資訊寫在官網容易找到的位置,寫成一句話就看得懂的句子,並請第三方網站更新過期的內容。之後再用同一組問題定期回頭看,確認答案有沒有跟著改。
參考來源
- Kalai 等人(2025):Why Language Models Hallucinate
- OpenAI:Why language models hallucinate
- NIST AI 600-1:Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile
- Google Cloud:什麼是 AI 幻覺?
- Anthropic:Reduce hallucinations
- Microsoft Learn:RAG evaluators(Groundedness)
- Google 搜尋說明:關於 Google 搜尋中的 AI 摘要
- Google:AI Overviews: About last week(2024)
- Mata v. Avianca, Inc., 678 F.Supp.3d 443(S.D.N.Y. 2023)(判決副本)
- Moffatt v. Air Canada, 2024 BCCRT 149