
十月第一週的行銷週會上,你面前的簡報出現了三個數字。你是台中一家有兩間館的月子中心的行銷負責人,你們每個月請代理商拿一份固定的問題清單去問 ChatGPT,看回答裡有沒有引用你們的官網。
這份固定追蹤的問題清單,就是所謂的題庫。原本是 99 題,九月內容組又請代理商加了 1 題,變成 100 題。這次週會看的,是代理商交來的九月月報,上面寫的引用率是 10%,也就是 100 題裡有 10 題的回答引用了你們的官網。
可是內容組說是 100%。因為九月新加的那一題是「第一胎,預算一個月 15 萬以內,台中有哪幾家月子中心可以讓先生一起陪住?」,而他們九月初剛改寫的「房型與費用」那一頁,就在這一題的回答裡被 AI 引用了。內容組看的,就是月報裡這一題的結果。
簡報最後一頁還有一個 54.5%,是有人把這一題的 100%,和其他 99 題的引用率直接平均出來的。那 99 題裡有 9 題引用了你們的官網,也就是 9/99,大約 9.1%。
如果你今天要拿其中一個數字,決定下個月還要不要繼續改其他頁面的話,到底該看哪一個?
這三個數字各自的算式都沒有問題,差別在算的範圍不一樣。內容組只看了新加的 1 題,代理商算了全部 100 題,而 54.5% 是把兩組的比例相加再除以二。會出現這種情況,是因為大家事先沒有講好一筆資料算什麼、分母要包含哪些回答、兩組數字要怎麼合併。
這篇講的引用率,是回答列出的來源裡有你們官網的比例;另一個常見的提及率,則是回答裡有提到你們品牌的比例。兩者的基本算法在 AI 能見度量測方法有完整說明,這篇只處理一件事:好幾組數字要放進同一份報表時,怎麼算才不會出錯。
54.5% 為什麼不能用:分組要加總再相除
先說結論,54.5% 要從簡報裡拿掉。把兩組的比例直接平均,等於讓只有 1 題的新題,和有 99 題的舊題各占一半的份量,結果就會偏向那 1 題的 100%。正確的做法是把分子和分母各自加總再相除,(1 + 9) ÷ (1 + 99),得到 10/100,也就是 10%,而 54.5% 比它高了 44.5 個百分點。
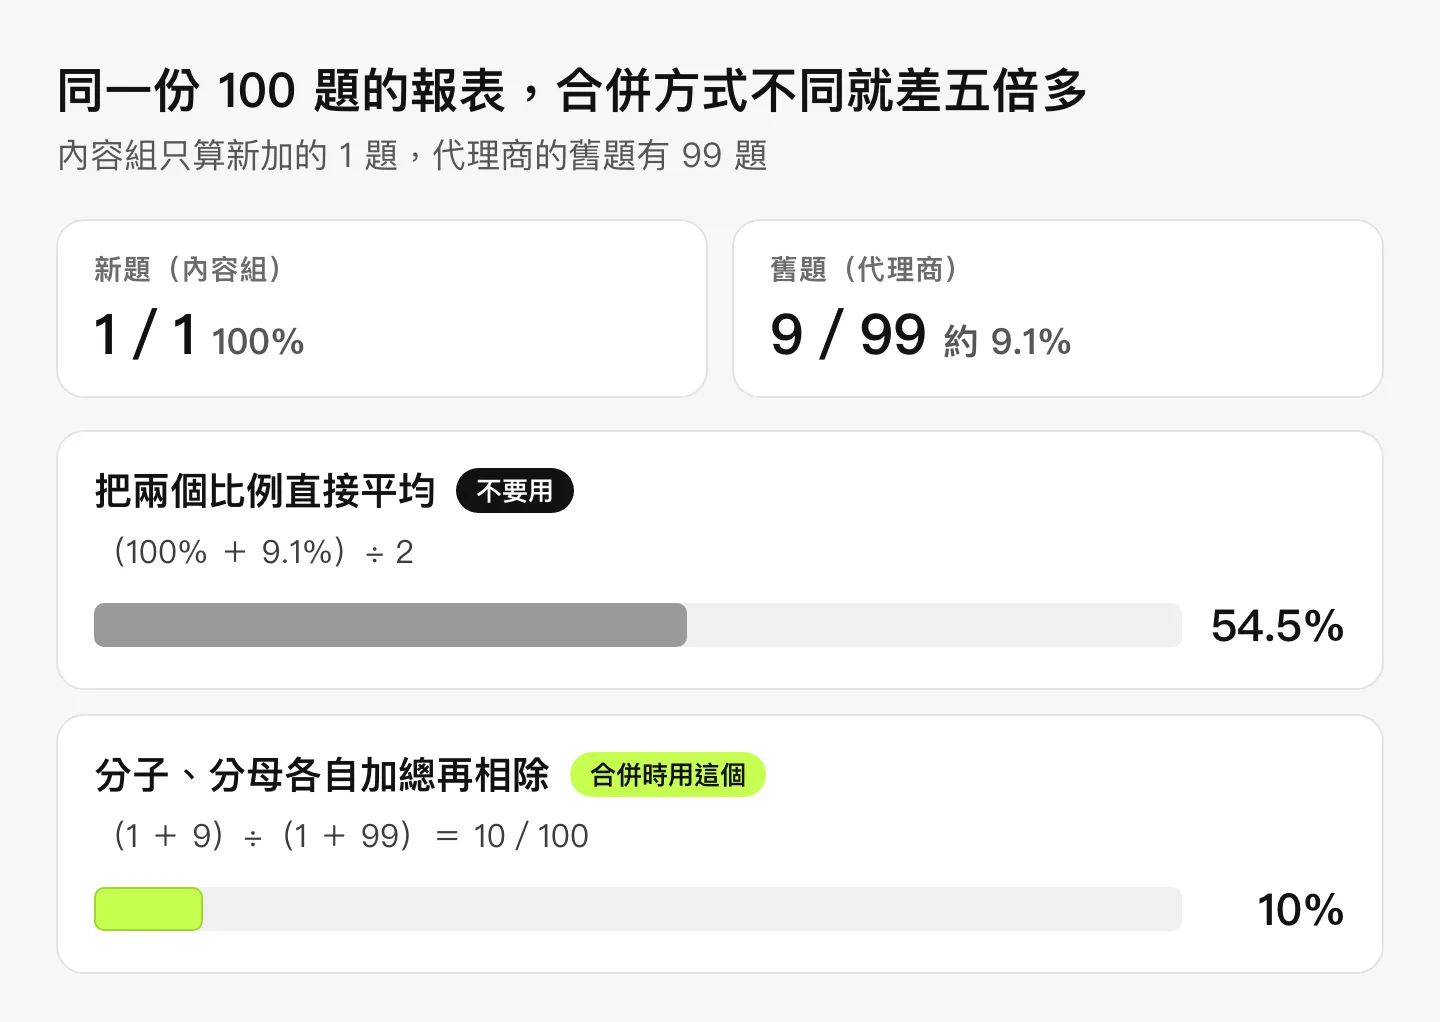 這是月報原本交來的數字。直接平均時,只有 1 題的新題和 99 題的舊題各占一半的份量,所以結果是 54.5%。
這個道理,拿你們自己的參觀轉訂率來想最清楚:
用北屯館兩種來源的參觀轉訂率來看同一件事
- 老客戶介紹來的:這個月有 2 組家庭,2 組都訂了,轉訂率 100%,就像只有 1 題的新題。
- 看網路廣告來預約的:有 98 組家庭,訂了 8 組,轉訂率約 8.2%,就像有 99 題的舊題。
- 兩種來源直接平均:約 54.1%,看起來像有一半的家庭都訂了,可是北屯館這個月實際是 100 組裡訂了 10 組,也就是 10%。
所以合併分組時,要把分子和分母各自加總再相除。
AI 的回答和來參觀的家庭有一點不同:有些題目根本沒拿到回答,所以加總之前,還要先確認分母裡的每一筆,都是真的拿到了回答,後面核對時會用到這一點。另外,加總的前提是兩組算的是同一種東西。這份月報的新題和舊題,算的都是「有幾題的回答引用了官網」,所以可以加在一起。
能拿來做決定的,是兩版都有的 99 題
拿掉 54.5% 之後,剩下 10% 和 100%,但這兩個也都不適合拿來決定要不要繼續改頁面。原因在題庫換過版本。
九月加了那 1 題之後,題庫就從 99 題的第 1 版,變成 100 題的第 2 版。新加的那一題八月根本沒有問過,所以它的 100% 沒有改寫之前的數字可以比,只能說明這一題現在有引用,沒辦法證明是改寫造成的。而全部 100 題的 10%,也沒辦法跟八月直接比,因為兩個月問的題目不一樣。
真正能拿來看改寫有沒有效果的,是兩版都有的那 99 題。內容組是九月初改寫的,所以八月的數字就是改寫之前,九月就是改寫之後,用同樣這 99 題前後比,才知道變化是不是來自改寫。
要讓前後兩個月比得起來,除了題庫,你們和代理商還要事先講好一份計算規則。它寫明什麼算一筆、什麼情況算引用、哪些名字算你們的品牌(例如回答裡寫「○○產後護理之家北屯館」算不算),以及比較品牌名單,也就是你們和要拿來一起比的那幾家競爭對手。題庫或計算規則只要改過,就要換一個版本名稱,而這次月報遇到的是下面這兩種:
| 改了什麼 | 月子中心的例子 | 建議做法 |
|---|---|---|
| 加題,但保留舊題 | 九月加了 1 題新題 | 月報寫明九月起是第 2 版題庫,要看趨勢時,只拿兩版都有的 99 題跟八月比 |
| 改了計算規則 | 九月起,回答裡寫「○○產後護理之家北屯館」也算提到你們 | 月報寫明九月起用「計算規則九月版」,九月前後的提及率不能直接比較;引用率看的是官網網址,不受這條影響 |
其他像是只多記一項資料、舊資料不完整這些情況,題庫版本管理有一步一步的做法。
請代理商在月報後面附上逐題清單
知道要比哪 99 題之後,你接著會想問,九月這 99 題的 9/99 到底對不對。光看月報上的比例是查不出來的,所以週會後,你可以請代理商在月報後面,補上八月和九月的逐題清單。
清單裡的每一行,就是一次觀測,也就是拿題庫裡的一題,在一個 AI 工具上問一次、把回答存下來。代理商每個月在 ChatGPT 上把每一題各問一次,所以九月應該是 100 行。每一行,你可以請代理商至少附上這些資料:
| 要附的資料 | 為什麼要有 |
|---|---|
| 這一筆的編號 | 每一筆都有自己的編號,才找得出被記了兩次的資料 |
| 題目和題庫版本 | 看得出這一題是第 1 版就有的舊題,還是九月新加的 |
| AI 工具、語言和地區 | 條件不同的回答,不能放在同一個比例裡算 |
| 實際問的時間 | 精確到分鐘、寫出時區,之後才查得到是哪一次 |
| 回答狀態 | 分得出這一筆是真的拿到了回答,還是沒拿到 |
| 原始回答的連結 | 代理商說有引用時,你打得開那一筆回答,看到官網網址確實在裡面 |
| 計算規則的版本 | 看得出這一筆是照哪一版規則判斷,例如「計算規則九月版」 |
回答狀態的部分,我會請代理商把每一筆標成下面五種之一:
- 有效:拿到完整的回答,可以判斷有沒有提到你、有沒有引用你。
- 空白:AI 有回應,但沒有實際內容。
- 錯誤:逾時或系統出錯,沒拿到回答。
- 被擋:AI 工具拒絕回答,或要求登入才能繼續。
- 沒跑到:排程根本沒有執行這一題。
我們開發的 Otlex 每次觀測也會記下回答裡有沒有提到品牌、有沒有出現你們的網域,以及引用和回答的位置,報表上的每個數字,都找得到是哪一次觀測得到的。
 Otlex 示範帳戶的總覽畫面。畫面上的每個比例,都是由一次一次的觀測加總算出來的。
拿九月月報逐項核對四件事
週會後一個多禮拜,代理商把八月和九月的逐題清單補給你了。我會照下面四件事一項一項看:
- 筆數有沒有對上。月報寫的是 100 題,清單上卻有 102 行。打開來看,有 2 題各出現了兩次,題目、AI 工具和問的時間都一模一樣,原來是代理商某天匯入失敗、把同一批資料重新匯入了一次,並沒有重新去問 AI。重新匯入的資料要沿用原本的編號,才看得出是重複的;如果代理商重新匯入時換了編號,就用題目、AI 工具和問的時間三項一起比對。刪掉多出來的 2 行之後,剩 100 行。
- 沒拿到回答的,有沒有被算成沒有引用。100 行裡有 3 行的狀態是錯誤,都是舊題,代理商的系統逾時,沒問到 AI。可是月報的 9/99,把這 3 題也算進了分母,當成「沒有引用」。這 3 題只是沒拿到資料,和 AI 回答裡真的沒有你們是兩回事,所以我會在計算規則裡寫明,空白、錯誤、被擋和沒跑到的回答,都不算進分母。這 3 題移出來之後,舊題的有效回答變成 96 筆,這 3 題下個月重跑。
- 每一筆引用都打得開原始回答。例如月報說新題有引用,你就在清單裡找到新題那一行,打開原始回答的連結,看你們官網的網址在不在回答列出的來源裡。舊題 9 筆、新題 1 筆,一共 10 筆,你逐一打開確認過。引用的網址要怎麼記、怎麼往回追查,可以看 AI 引用追蹤。
- 每個數字有沒有標版本。九月月報上的每個比例,旁邊都要寫明是第 2 版題庫、計算規則九月版,還有這次有幾筆因為錯誤沒算進去。
四件事核對完,九月月報的數字是這樣:
| 核對的項目 | 核對之前 | 核對之後 |
|---|---|---|
| 清單筆數 | 月報寫 100 題,代理商補來的清單有 102 行 | 刪掉 2 行重複匯入的,剩 100 行 |
| 有效回答 | 月報沒有寫 | 97 筆,另外 3 筆錯誤下個月重跑 |
| 兩版都有的 99 題 | 9/99,約 9.1% | 9/96,約 9.4% |
| 九月新加的 1 題 | 1/1 | 1/1,八月沒有問過 |
| 全部 100 題 | 10/100,10% | 10/97,約 10.3% |
八月的清單你也照同樣的方式看過:八月 99 題都拿到了回答,而九月出錯的那 3 題,八月都沒有引用。所以只比兩個月都拿到回答的 96 題,八月是 7 筆有引用,約 7.3%。
核對完的數字要放成什麼樣的畫面,可以看 AI 搜尋監測儀表板。
下一次週會上的三個數字
十月第三週的週會上,你把 54.5% 從簡報裡拿掉,改成三個數字並排,每個旁邊都註明了範圍:
- 全部 100 題:有效回答 97 筆,10 筆有引用,約 10.3%,另外 3 筆錯誤下個月重跑。
- 九月新加的 1 題:1/1,只有 1 題,而且八月沒有問過,沒有改寫之前的數字。
- 兩個月都拿到回答的 96 題:八月 7 筆有引用,約 7.3%;九月 9 筆,約 9.4%。
這樣一來,開頭那個問題就有答案了。新題的 100% 只有 1 題,又沒有改寫前的數字可以比,所以不能拿它來決定方向。真正該看的是那 96 題,從八月的約 7.3% 變成九月的約 9.4%,而你對照兩個月的清單,打開九月多出來的那 2 筆引用回答,發現引用的都是改寫過的「房型與費用」那一頁。
不過這個變化只多了 2 筆,每題又只問一次,3 筆錯誤也還沒重跑,所以它只夠支持你再試試看。你們決定十月再改「陪住規定」和「新生兒照護」這兩頁,並請代理商在這兩頁上線之後才跑十月這一輪;如果十月月報上,兩版都有的那些舊題,引用的比例維持或繼續增加,才算真的看到了改寫的效果。
只要每個比例旁邊都附上分子、分母和版本,內容組、代理商和你就是在算同一個範圍。
常見問題
代理商每題只問一次,夠嗎?
AI 每次的回答不太一樣,所以每題只問一次時,一兩題的變化很可能只是剛好。有些代理商會每題問三次,這時候要先講好引用率的分母怎麼算。例如 100 題各問三次是 300 筆,其中 30 筆有引用,用 300 筆當分母是 10%;可是這 30 筆如果分散在 18 題,用「三次之中至少一次有引用」的題數來算,就是 18/100,也就是 18%。不管選哪一種,前後月份都要用同一種算法。
為什麼不能把各分組百分比直接平均?
因為每一組的題數不一樣。以開頭的例子來說,在逐項核對之前,月報上的新題 1/1 和舊題 9/99 直接平均是 54.5%,但合併計算是 10/100,也就是 10%,兩者差了 44.5 個百分點。兩組算的是同一種東西、計算規則也相同時,才把分子和分母各自加總再相除;算的東西不一樣,就分開列,不合併。
題庫裡的題目要怎麼寫?
照顧客實際會怎麼問 AI 來寫。在 Google 搜尋時,大家習慣打「台中 月子中心 推薦」這種關鍵字,可是問 AI 的時候,通常會把自己的條件一起講出來,而 AI 回答時也會依這些條件挑出不同的月子中心。月子中心九月加的那一題,就是照這種方式寫的:
| 關鍵字寫法 | 實際會問 AI 的方式 |
|---|---|
| 台中 月子中心 推薦 | 第一胎,預算一個月 15 萬以內,台中有哪幾家月子中心可以讓先生一起陪住? |
| 月子中心 價格 | 台中北屯附近的月子中心,雙人房住 28 天大概要多少錢?新生兒照護有包含在裡面嗎? |
| 月子中心 評價 | 我在考慮○○產後護理之家,它的嬰兒室晚上也有護理師顧嗎?跟附近其他家比起來怎麼樣? |
題目要分哪些類型、怎麼避免同一題換字重複,可以看 AI 搜尋題庫怎麼設計。
沒拿到回答的資料可以先用零補上嗎?
我會照實標出狀態,不填 0。沒拿到回答、缺原始回答或版本不明的資料如果填了 0,報表上就會變成「沒有引用」,讀的人分不出是資料出了問題,還是品牌真的沒被引用。先記下原因和筆數,等重跑或補齊之後再重算。
Search Console 的生成式 AI 成效報表,可以合併進同一份報表嗎?
可以放進同一份報表,但不要跟自己的觀測數字合併計算。
Search Console 的生成式 AI 成效報表從 2026 年 8 月 31 日起開放給全球的網站,顯示的是你的網頁在 Google AI 摘要(搜尋結果最上方由 AI 寫的那段回答)和 AI 模式(在 Google 搜尋裡直接跟 AI 對話的功能)裡的曝光次數,可以依網頁、國家/地區、日期和裝置來看,但看不到逐題的回答,也沒有品牌提及。它的日期以太平洋時區為準,下載的檔案裡沒有資料的地方也會變成 0,所以我會把它放在另一個區塊,標明資料來源和時區。
參考來源
以下依官方文件整理,Search Console 報表的開放範圍與欄位以官方說明當下為準。