
你在一家做雲端會計軟體的台灣公司負責行銷,每兩週會拿同一組 20 個問題去問 ChatGPT,看它有沒有推薦自家品牌。結果記在一張試算表上,每一題只寫「有推薦」或「沒推薦」。
其中第 3 題是「我們是 10 個人的貿易公司,想從 Excel 換成雲端會計軟體,有推薦的嗎?」,9 月 1 日那一輪記的是有推薦,9 月 15 日卻變成沒推薦。而你第一個想到的,是 9 月 8 日剛上線的新價格頁是不是改壞了。
可是回頭一查,這兩週改過的東西不只價格頁。業務同事因為好幾個客戶都問到發票,在 9 月 15 日那一輪之前,把這一題改成「10 個人的貿易公司,要能開電子發票,推薦哪一套雲端會計軟體?」。另一位同事則覺得 AI 只列出名字不算真的推薦,把判斷規則從「出現在推薦清單裡就算推薦」,改成「要附上理由才算推薦」。所以 9 月 15 日的「沒推薦」,至少有四種可能的原因:
- 價格頁改壞了,ChatGPT 不再推薦你。
- 題目換了,加上電子發票之後,ChatGPT 想到的是別家。
- 判斷規則換了,回答裡其實還有你,只是沒附理由,所以不算推薦。
- AI 自己變了,同一句話在不同時間,本來就可能得到不同的回答。
而試算表上只有「有推薦」和「沒推薦」,回答原文一份都沒存,所以這四種原因你一個也排除不了。
像這樣固定拿來問 AI 的一組問題,就叫做題庫。題庫一開始該涵蓋哪些問題,可以先看 AI 搜尋題庫怎麼設計;題庫開始定期跑之後,接下來要處理的,就是每一輪要記什麼、改題目時要留下什麼,以及改了之後前後的數字還能不能比。我會一直拿這家會計軟體公司當例子,最後再回來看第 3 題到底怎麼了。
先分清楚是哪一種東西改了
前後兩輪的結果不一樣時,我會先確認四件事有沒有改。先說明表格裡的三個詞:提及,是回答裡出現品牌名稱;引用,是回答把你的網頁列為來源;推薦,則是回答建議讀者選你。
| 改了什麼 | 指的是 | 會計軟體公司的例子 | 對前後比較的影響 |
|---|---|---|---|
| 題目 | 某一題的問題文字 | 第 3 題加上「要能開電子發票」 | 回答可能整個不同 |
| 題單 | 這一版題庫收了哪幾題 | 如果下一輪把 20 題加到 25 題 | 算比例時的總題數變了 |
| 執行條件 | 用哪個引擎、什麼語言、地區、裝置,有沒有登入去問 | 如果下一輪改去問 Google 的 AI 模式(AI Mode) | 拿到回答的環境變了 |
| 判斷規則 | 怎麼判定提及、引用和推薦 | 「列在清單就算推薦」改成「要附理由才算」 | 回答沒變,結果也可能變 |
除了這四件事,網站內容的修改也要另外記下來,例如哪一天改了哪個頁面的哪一段。它不屬於題庫,但你真正想知道的,通常就是這一次修改有沒有效果,所以要跟題庫的版本記在同一份紀錄上。
這四件事裡,題目最容易被改。因為好的題目本來就是顧客帶著自己的處境去問 AI 的那句話,例如「每個月要開兩百多張電子發票,會計只有一位兼職,哪一套比較省事?」,而不是「雲端會計軟體 推薦」這種關鍵字,所以只要有人聽到新的客戶問題,就會很想把條件加進去。而多一個條件或少一個條件,問的就已經是另一件事了。
關鍵字要怎麼改寫成這種問法,可以看 AI 搜尋題庫怎麼設計。
既然一個條件就能讓題目變成另一題,你就需要一個方法分辨每一輪問的是哪一題,所以這四件事我會各自編號:
- 題目版本:每一題自己的版本。第 3 題原本的問法是第 1 版,加上電子發票的是第 2 版。
- 題單版本:整份題庫收了哪幾題。只有加題、刪題或停用時才升版,單一題改了問法,題單版本不用跟著升。
- 執行條件與判斷規則:同樣各自編號,例如「列在清單就算」是判斷規則第 1 版,「要附理由才算」是第 2 版。
能比、只能分開列,還是先暫停
知道改了什麼之後,就可以判斷兩輪的結果能不能放在一起比。我會分成三種情況:
- 可以直接比:四件事都沒改,只有網站內容或查詢日期不同。不過 AI 的回答本來就會變,所以報告上要寫出這是哪一段期間的結果。
- 只能分開列:四件事裡有一件改了。這時把兩輪的結果分開列出來,各自寫清楚用的是哪一版題目、題單、條件和規則,不要算差了多少,因為算出來的差距,可能只是題目或規則改了造成的。
- 先暫停:資料不齊的時候,先在報告上寫明資料不足,補齊之後再決定要不要重跑。常見的情況有:
- 回答原文沒有存,或者找不到了。
- 不知道當時用的是哪一版題目,或用什麼條件問的。
- 來源網址是人工猜著補上去的。
- 回答中途被截斷,沒有完整讀過。
有兩種改動特別容易被忽略。第一種是題目只改了幾個字,例如加上「台灣」「10 個人」「電子發票」,就算只改了幾個字,顧客要做的選擇也可能已經不同,所以要開新的題目版本。第二種是判斷規則:第一輪把「列在清單裡」算成推薦,第二輪改成要附理由才算,這時就算回答一個字都沒變,只要有回答只列了你的名字、沒附理由,推薦率(推薦你的回答占全部回答的比例)就會掉。
規則改了的話,可以把舊回答拿出來,用新規則重新判斷一次;或者反過來,新回答也照舊規則判斷。兩種選一種,並在報告上寫明用了哪一種,但前提都是舊回答的原文還在。
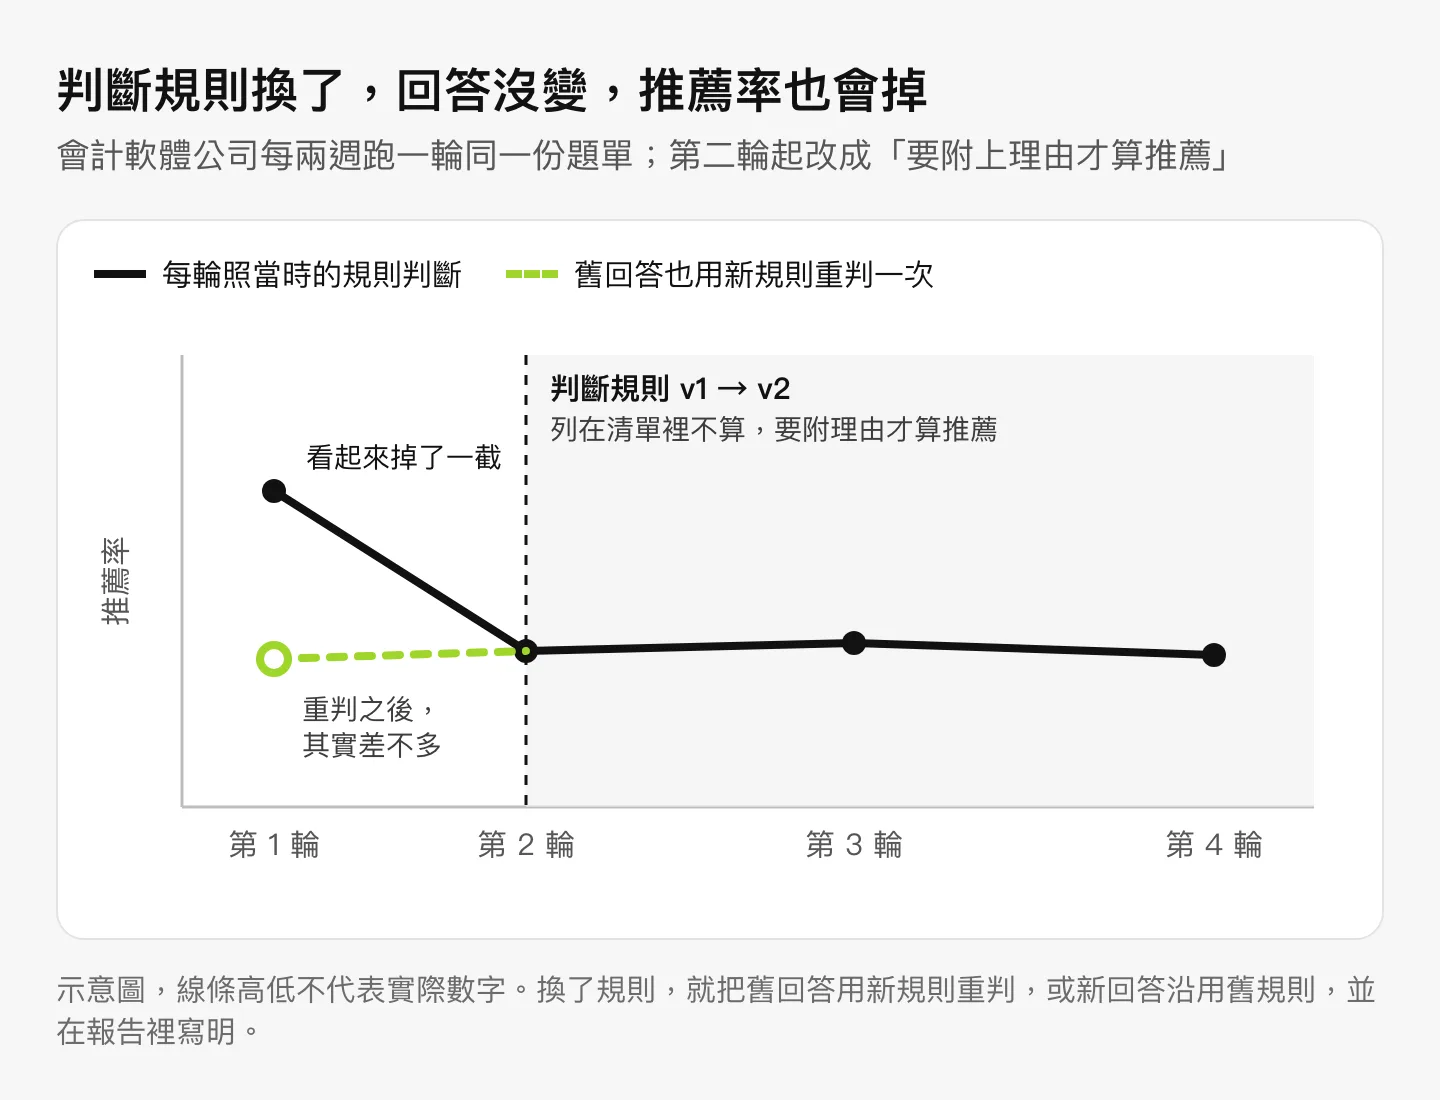 回答沒變,只是規則換了,推薦率就會掉。舊回答用新規則重新判斷一次,前後才比得起來。
題單改了也一樣,如果下一輪加了 5 題,就只拿兩輪都問過的那 20 題來算比例,並在報告上寫清楚。
回到會計軟體公司。9 月 1 日和 9 月 15 日之間,題目和判斷規則都改了,所以最多只能分開列;更麻煩的是兩輪都沒存回答原文,當時是不是用同一個帳號、有沒有登入也沒記,所以其實是第三種情況,要先暫停。這就是為什麼你現在還沒辦法說價格頁到底有沒有問題。
這兩輪的資料已經補不回來了,所以能做的是從下一輪開始重新記:把條件寫下來,第 3 題的新舊兩版各問一次,原文全部存好。這一輪會變成新的起點,而不是拿來和 9 月 15 日相減。在那之前,先把業務改題目那件事補上紀錄。
改題目時,要留下哪些紀錄
業務同事加上「要能開電子發票」,是因為客戶真的常問,所以這樣改沒錯;只是改完之後沒有留下任何紀錄,兩週後大家只看到結果變了,卻沒有人知道題目已經不一樣。所以每改一題,我會留下四樣東西:
- 舊的題目文字。
- 新的題目文字。
- 為什麼改,例如「客戶常問電子發票,原本的題目沒有這個條件」。如果只寫「優化」,半年後連你自己都想不起來改了什麼。
- 從哪一天的哪一輪開始用新版本。
另外有三條規則,我覺得比表格要記哪些項目還重要:
- 測試用的題目和正式題庫分開放。例如業務想先試試「記帳士會推薦哪一套雲端會計軟體」,就先放在測試區跑幾輪,確定要追蹤再移進正式題單,不然之後很難分辨哪幾段資料該排除。
- 臨時加的題目要寫到期日。例如產品剛改版、要先觀察幾週的題目,到期時決定要轉成正式、修改還是停用,否則「暫時」通常會變成永久。
- 不再用的題目停用就好,不要刪掉。因為一旦刪掉,舊報表上的數字就查不回是怎麼來的了。
每問一題,要記下哪些東西
要讓下一輪比得起來,就要先有一份比較基準,也就是之後每一輪都拿來對照的那一份紀錄。我會先把想比的事寫成一句話,例如「同一組 20 題,在網站改版前後,品牌有沒有被提到、官網有沒有被引用」,再照這句話決定每問一題要記下哪些東西:
| 要記的資訊 | 例子 |
|---|---|
| 編號 | 這一筆的編號,要能從編號找到當次的回答原文 |
| 題單版本、題號、題目版本 | 題單第 1 版、第 3 題、題目第 2 版 |
| 引擎與模式 | 「ChatGPT 搜尋」或「Google AI 摘要」,不要只寫「AI」 |
| 語言、地區、裝置、登入狀態 | 繁體中文、台灣、桌機、未登入 |
| 執行時間 | 實際問的日期和時間 |
| 回答狀態 | 有效、空白、錯誤、被擋、不完整五種之一 |
| 回答原文與畫面上的來源 | 原文本身或存放位置,以及回答裡列出的來源網址 |
| 判斷結果與規則版本 | 有沒有提及、引用、推薦,用的是第幾版規則,不好判斷時留一句理由 |
| 網站內容版本 | 當時頁面是哪個版本,或修改摘要 |
這裡面最常被省略的是回答原文。如果你只留下「有推薦」這個結果、卻沒有存原文,下一輪看到差異時,就分不出是回答變了還是判斷方式變了,會計軟體公司的試算表就是這樣。
回答狀態也要先分開記,因為沒拿到回答,和回答裡沒提到你,是兩件不同的事:
| 回答狀態 | 意思 | 算不算進有效回答 |
|---|---|---|
| 有效 | 拿到可讀的回答,可以照規則判斷 | 算 |
| 空白 | 回傳空內容 | 不算 |
| 錯誤 | 執行或服務出錯 | 不算 |
| 被擋 | 被系統擋下來,例如要求登入或拒絕回答 | 不算 |
| 不完整 | 回答中途截斷 | 先不算,等人工看過再決定 |
這會直接影響比例怎麼算。提及率是「有提到你的回答數」除以「有效回答數」,後面這個被拿來除的數字,就是分母。例如某一輪 20 題裡有 2 題因為服務錯誤沒跑完,分母要用 18 還是 20,就要在一開始講好。如果把那 2 筆錯誤當成沒提到、再除以 20,等於把兩次根本沒問成功的題目,算成了 AI 沒提到你。
每一輪怎麼跑
跑之前:確認題目和條件
每一輪開始前,先確認這次用的是哪一版題單和題目。跑到一半不要改題目,要改就等這一輪結束後再開新版本。如果業務是在 9 月 15 日那一輪跑到一半才改第 3 題,同一輪裡就會混著兩種問法,連分開列都做不到。
引擎和模式要分開記,因為 Google 的 AI 摘要和 AI 模式可能使用不同的模型與技術,兩邊列出的回答和連結可能不一樣(Google:AI 功能與你的網站)。之後如果你也想追蹤 Google,這兩個就要當成兩個引擎各記一筆。
登入狀態也會影響結果。ChatGPT 搜尋網路時,會依 IP 位址推估你大概在哪裡;開了記憶功能的帳號,改寫搜尋字詞時也可能用到已存的記憶(OpenAI:用 ChatGPT 搜尋網路)。所以如果一輪用同事登入的帳號跑、下一輪改用未登入的視窗跑,兩邊的差異可能跟你的網站完全無關。
跑的時候:先把原文存下來
拿到回答後,先把原文存下來,再去判斷提及、引用和推薦。回答下方通常會有列出來源的小方框,叫做來源卡,上面看得到什麼就記什麼。如果來源卡只顯示網域,例如 example.com,就只記網域,不要自己補成 example.com/pricing,因為補上去的那一段,下一輪沒有人分得出是看到的還是猜的。
另外,回答產生的時間,和你打開來源頁去讀的時間,通常不是同一刻。例如回答引用了你的價格頁,你隔一週才點開,那時價格頁可能又改過一次,所以兩個時間都要留下來。
存檔的檔名也要用同一套寫法,例如「題單第1版_第3題_題目第2版_ChatGPT_2026-09-29」。檔名只寫日期不夠,還要寫版本,因為只寫 2026-09-29 的話,只看得出那天有人問過一次,看不出用的是哪一版題目。
跑完之後:打開來源核對引用
AI 回答附的網址,不一定能證明旁邊那句話。OpenAI 也提醒,搜尋結果和引用可能不完整、過時或錯誤,建議打開來源確認它真的支持回答,並看它是什麼時候發布或更新的(OpenAI:用 ChatGPT 搜尋網路)。
核對完來源,就能分清楚是哪一種。例如回答把你的品牌列進清單,來源卡列的卻是一篇別人寫的比較文章,那就是提及,不是引用;而要像「如果公司要開電子發票,可以考慮 X」這樣把你和條件、理由連在一起,才算推薦。提及和引用怎麼分開記,可以看品牌提及與引用差別;推薦怎麼判斷,可以看 AI 提及與推薦差別。
回到第 3 題:推薦到底為什麼不見了
9 月 29 日那一輪,你照這篇的做法重新開始。條件寫下來是未登入、台灣、桌機,20 題全部跑完,第 3 題用第 2 版;另外再多問一次第 3 題的第 1 版當對照。每一筆的原文都存下來,判斷規則用第 2 版。這一輪有 2 題因為錯誤沒拿到回答,所以有效回答是 18 筆。
第 3 題的兩個版本是這樣回答的:
- 第 1 版(從 Excel 換):ChatGPT 列了四套軟體,你的品牌在裡面,只是沒附理由。照第 2 版規則不算推薦,照第 1 版規則就算。
- 第 2 版(要能開電子發票):ChatGPT 列了三套軟體,理由都寫著開發票很方便,裡面完全沒有你。
9 月 15 日問的已經是第 2 版,而第 2 版在 9 月 29 日也沒有提到你,所以 9 月 15 日的「沒推薦」,用題目改了就解釋得通。
再看價格頁。它 9 月 8 日就上線了,第 1 版在 9 月 29 日仍然把你列進清單,所以看不出價格頁讓你從原題裡消失。第 3 題的變化,看起來是題目改了造成的,不像是價格頁;只是只重問了一次,還不能排除 AI 自己的變動。
接著你在紀錄上寫下一個推測:官網只在功能列表裡寫了一行「支援電子發票」,沒有一頁講清楚怎麼開、一個月能開多少張。所以你在 10 月 6 日補了一頁電子發票說明,並照下面四步記下來:
- 改之前先存一份基準:9 月 29 日那一輪就是基準,存好就不再動它。
- 記下改了什麼:新增哪一頁、寫了哪幾段、哪一天上線,以及上線後實際打開確認過的版本。「缺電子發票說明頁」要寫明是推測,不然之後每一輪的判斷,都會建立在一個沒被證實的原因上。
- 用同一組題目重跑:以新頁上線那天當第 0 天,第 7 天和第 28 天各跑一輪,題目、題單、執行條件和判斷規則都用 9 月 29 日那一版。
- 比較回答本身,不只比較比例:除了提及率,還要寫出哪些回答新提到你、哪些不再提到你、引用的來源換成哪一頁,以及推薦的理由有沒有變。
第 7 天是 10 月 13 日,剛好也是例行的那一輪,題單和第 3 題的兩個版本都照 9 月 29 日那樣問。四件事都沒改,只有網站內容不同,所以這兩輪屬於可以直接比的情況。結果第 2 版題目的回答開始把你列進清單,來源卡出現了那一頁電子發票說明,但還沒有附理由,照第 2 版規則仍然不算推薦。這一輪有效回答只有 16 筆,所以你在報告上寫的是兩輪各自的提及率和分母,並且列出第 3 題從沒提到你、變成提到你並引用新頁。
至於第 28 天那一輪,還要再等。如果到時候第 2 版題目仍然提到你,甚至開始附上理由,才比較能說這一頁有幫助;而「AI 已經更喜歡這個品牌」這種結論,只跑兩輪還說不出來。
為什麼不能只測一次,這題 FAQ 有比較短的說明;改版前後的差異怎麼判斷算不算內容的功勞,可以接著看 AI 內容修改前後怎麼測;第一次建立基準要準備哪些資料,則可以看 AI 搜尋的第一份基準怎麼建立。
另外要記得,比較基準只能固定你自己的條件,AI 的回答本身怎麼變,它管不到;就算頁面符合所有要求,Google 也不保證一定會顯示它(Google:針對生成式 AI 功能優化網站)。Google Search Console 是 Google 給網站管理者看搜尋成效的免費工具,裡面的「生成式 AI 成效報表(搜尋)」看的是網站連結在 AI 摘要和 AI 模式裡的曝光次數(Search Console 說明),看不到 ChatGPT 怎麼回答,所以要和你逐題存下來的回答紀錄分開保存。
如果你不想自己維護這些表格,我們開發的 Otlex 會用同一份題庫,每天觀測 ChatGPT、Google AI Overview、Google AI Mode、Gemini、Grok、Perplexity、Claude 回答裡的提及、引用與推薦,並保存每一輪的原始回答和來源;帳戶實際能開哪幾個引擎,依方案而定。
常見問題
題目只改一個字,也要開新版本嗎?
先看那個字有沒有改變問的人是誰、要做什麼事、帶了什麼條件。只是修正錯字,意思沒變的話,在修改紀錄裡說明一下,沿用原本的版本就好。但從「比較」改成「推薦」,或加了「台灣」這種條件,就要開新版本,因為那一個字改掉的是整題想問的事。
跑失敗的紀錄要不要刪掉?
留著。把失敗的狀態和原因記下來,再照一開始講好的規則,決定它算不算進有效回答。刪掉失敗紀錄的報表雖然看起來比較乾淨,但有效回答從 18 筆變成 16 筆時,就沒有人說得出原因了。
來源網址打不開,引用要記成「沒有」嗎?
要分成兩件事來記。來源卡當時確實列了這個網址,今天點進去卻顯示找不到頁面(404),那就是當時有引用、但這一頁現在可能被移掉了。如果直接記成「沒有引用」,之後就分不出是回答沒給來源,還是那一頁後來不見了。
多久重跑一次才有意義?
要看你想回答什麼問題。想知道某一次修改有沒有效,就像會計軟體公司這樣,在例行的每兩週一輪之外,以上線日為準加跑第 7 天和第 28 天。想知道 AI 平常的回答變動有多大,就要跑得更密,例如每天跑,才看得出哪些變化是 AI 自己的起伏。