
週一早上,一家做冷凍水餃的公司開週會,業務、生產、客服三個人花了四十分鐘,談完年節禮盒的訂單、紙盒報價和上週的退貨。散會後,主持會議的業務雅婷還要花半小時把紀錄打出來寄給大家,裡面有七件事要有人去做。
AI 會議記錄想省的就是這半小時。問題是,AI 整理出來的待辦,能不能直接寄出去?如果 AI 把雅婷說的「試吃品這個我來寄」派給了客服佩君,雅婷以為佩君會寄、佩君以為不關她的事,客戶就等不到試吃品。我們把這場週會濃縮成 4 分半的劇本、錄成音檔,交給本機的語音辨識和三個開源模型實際跑了一遍。數字和日期大多是對的,出錯的是名字、縮寫,還有誰要做什麼。
這篇談的是一場會議怎麼從錄音走到交辦。要替全公司挑哪一家的 AI 助理,是另一個決定,可以先看企業版 AI 助理怎麼選。
AI 會議記錄在做哪三件事
不管用哪個工具,AI 做會議紀錄都是三段:先把聲音錄下來,再轉成逐字稿,最後由語言模型整理成決議、待辦和還沒決定的事。有些產品三段包在一起,按一個鍵就交出摘要;有些要自己接,例如手機錄音、上傳到一個服務轉文字、再貼給另一個 AI 整理。
| 環節 | 在做什麼 | 常見的錯 | 要先決定的事 |
|---|---|---|---|
| 錄音 | 收進每個人的聲音 | 只錄到自己的麥克風,線上會議戴耳機時對方的聲音進不來 | 誰按錄音、開場怎麼告知與會者 |
| 轉逐字稿 | 把聲音轉成文字,最好分出誰說了哪句 | 人名、客戶名、產品名、英文縮寫轉錯;沒有分講者 | 用哪個語音辨識、支不支援中文 |
| 整理 | 從逐字稿抓出決議與待辦 | 漏掉、派錯人、把「下週一」換成錯的日期 | 誰在寄出前核對 |
三段的資料也各自流到不同地方。錄音檔可能留在手機、留在會議系統、上傳到雲端後刪除;逐字稿和摘要則跟著存放的服務走。選工具之前,先把這三段各會經過哪裡寫下來,後面談同意和保存時才講得清楚。
先看公司在用的會議系統
會議如果本來就在 Teams 或 Google Meet 上開,第一步是看系統內建的功能能不能用;實體會議或要跨系統,才考慮另外的錄音工具。下面把常見的幾種做法放在一起比較:
| 做法 | 中文會議 | 要什麼方案 | 錄音與紀錄放在哪 | 分得出誰說的嗎 |
|---|---|---|---|---|
| Teams 會議回顧(intelligent recap) | 支援,語言清單含繁體中文(台灣) | Teams Premium 或 Microsoft Copilot 授權;會議要開逐字稿,AI 摘要要 5 分鐘以上 | 錄音存在公司的 OneDrive 與 SharePoint;組織內受邀的人看得到 | 逐字稿標出誰說了什麼 |
| Google Meet「幫我做筆記」 | 不支援,目前只有英、法、德、義、日、韓、葡、西 8 種;Meet 的逐字稿也是這 8 種 | 符合資格的 Workspace 版本或 Google AI 方案 | 存成召集人雲端硬碟「Google Meet」資料夾裡的文件,依召集人的設定分享 | 說明頁沒有提到 |
| ChatGPT 錄音模式(Record) | 說明頁寫英文效果最好,其他語言的準確度不一定,中文要自己試 | Plus、Pro、Business、Enterprise、Edu;只能用 macOS 桌面 App;單次最長 4 小時;Enterprise 和 Edu 工作區要管理員先開啟 | 錄音轉完就刪;逐字稿與摘要跟其他對話一樣依工作區設定保存 | 可以分辨多位講者 |
| Notion AI 會議筆記 | 支援中文 | Business 或 Enterprise 方案;每人每天上限 10 小時 | 紀錄是 Notion 頁面;錄音檔預設不保存,工作區擁有者開啟後才存在錄音者的裝置上 | 講者標記目前只支援英文 |
| 雅婷逐字稿 App(台灣人工智慧實驗室出品,和例子裡的雅婷無關) | 支援,中文、台語、英文、日語、粵語都能轉;官方頁主打逐字稿,整理待辦要另外交給 AI | App 和網頁版都能用,用量依轉錄時數計算,方案看官網 | 錄音上傳到雅婷的服務轉成逐字稿,存放與刪除方式看它的隱私權政策 | 可以分辨多位講者 |
| Plaud 錄音裝置+App | 支援繁體中文(國語、粵語、閩南語);一段錄音只能選一種語言,中英夾雜的段落可能比較不準 | 要買 Plaud 的錄音裝置,附每月 300 分鐘的免費方案,超過要升級付費方案 | 錄音同步到 App 後,在 Plaud 的雲端轉逐字稿和摘要 | App Store 的說明有講者標籤 |
| 本機 Whisper+開源模型 | 可以;部分模型的輸出會夾簡體字(見下節實測) | 一台記憶體夠大的電腦,沒有授權費 | 全部留在這台電腦 | 預設沒有,要另外裝工具 |
用 Microsoft 365 的公司,Teams 會議回顧最省事:錄音、逐字稿、摘要都在公司自己的環境裡,權限也沿用 Teams 的設定。只要確認兩件事:授權有買,會議有開逐字稿。另外會議要超過 5 分鐘才會產生 AI 摘要,一般的週會不成問題。
用 Google Workspace 的公司就麻煩一點。Google Meet 的「幫我做筆記」目前不支援中文,連 Meet 自己的逐字稿也不支援,全中文的會議得另外錄音、交給別的工具轉。ChatGPT 的錄音模式和 Notion 都能做這件事,前者只在 Mac 上,後者要 Business 以上的方案;選哪一個,要看公司原本就在用哪一套、帳號是不是公司統一管理。
實體會議、或公司沒有統一的會議系統時,也可以改用獨立的錄音或逐字稿工具。雅婷逐字稿是台灣團隊做的,中文和台語都能轉,適合主要只要逐字稿的場合;Plaud 則是一個隨身的錄音裝置,錄完在 App 裡轉逐字稿、出摘要。這兩種工具都會把錄音交給業者的服務處理,所以採購前一樣要看它的隱私權政策,以及帳號能不能由公司統一管理。
我們拿一場虛構的週會實測
我們沒有逐一測雲端工具,但它們做的也是同樣三段,所以下面這些錯,用雲端工具時一樣要對照檢查。
2026 年 10 月 15 日,我們在一台 Apple M4 Pro、24 GB 記憶體的 Mac 上做了這個測試。劇本就是開頭那場週會,濃縮成 21 句、1,024 個字:業務雅婷主持,生產志明、客服佩君一起開。我們刻意埋了四個陷阱:
- 講錯又改口的數量:訂購數量先說 1,200 盒,再改成 1,500 盒。
- 英文縮寫:一句「有客人在 IG 留言」。
- 只講一次的承諾:志明說最晚 12 月 10 日要生產完,之後沒有人再提。
- 只用「我」交辦的事:例如雅婷說「這個我來寄」,指的是寄試吃品,沒講自己的名字。
劇本用 macOS 內建的三個台灣中文語音分角色念出來,接成一個 4 分 33 秒的音檔。合成語音發音標準、沒有人搶話、也沒有背景噪音,比真實會議好處理得多,所以真人開會只會錯得更多。
轉逐字稿:數字多半對,名字和縮寫常錯
語音辨識用的是 faster-whisper,它是 OpenAI 開源語音模型 Whisper 的加速版,在這台 Mac 上只用處理器(CPU)跑,沒有另外的顯示卡。我們試了三種大小,另外對其中兩種加上「名詞提示」:一段繁體中文寫的會議背景,列出與會者名字、客戶名、產品名和縮寫。
| 模型 | 轉 4 分 33 秒要多久 | 字元錯誤率(每 100 字錯幾字) | 簡體字(輸出總字數中有幾個) | 26 個關鍵詞轉錯幾個 |
|---|---|---|---|---|
| small | 36 秒 | 11.4% | 248/1,050 | 6 |
| medium | 132 秒 | 5.5% | 6/927 | 5 |
| large-v3-turbo | 71 秒 | 7.3% | 242/1,044 | 5 |
| medium+名詞提示 | 125 秒 | 9.8% | 1/983 | 3(但漏了 49 個字) |
| large-v3-turbo+名詞提示 | 73 秒 | 7.3% | 4/1,045 | 4 |
26 個關鍵詞是劇本裡的人名、客戶名、產品名、英文縮寫和數字。字元錯誤率是先把簡體轉成繁體、中文數字轉成阿拉伯數字,再和原稿逐字比。原稿是 1,024 字,各模型輸出的總字數不一樣,是因為有的會漏字、有的會多出字;加了提示的 medium 特別標出來,是因為它整段漏掉了一句話。
 同一段錄音的轉錄對照,紅字是轉錯的地方。
金額、數量和日期幾乎都轉對了。1,200 改口成 1,500、單價 285 元、12 月 18 日交期、11 月 3 日寄試吃品,五次轉錄的數字都沒出錯。錯的是名字:
- 客戶「青禾」變成「清和」
- 同事「佩君」變成「配君」
- 產品「韭黃鮮蝦」變成「九黃鮮蝦」
- 「MOQ」(最低訂購量)變成「MART」
這些詞平常很少有人寫,模型沒看過幾次,就容易挑一個常見的同音字。
最麻煩的是英文縮寫和意思整個翻過來的句子。「有客人在 IG 留言」被轉成「1 個留言」,加了名詞提示的 medium 甚至轉成「1 月 6 號留言」,平白多出一個日期。turbo 加提示後,把「少一包的那筆,我已經補寄了」轉成「我已經不記了」,意思正好相反。
名詞提示的效果也不一致。turbo 加了提示,簡體字從 242 個降到 4 個,客戶名和佩君都轉對了,志明卻變成「致命」;medium 加了提示反而漏掉一段話,標點變成奇怪的符號。名詞提示有用,但要用自己的模型和錄音試過,不能想當然。
另外,五份逐字稿都是一長串話,看不出哪句是誰說的。faster-whisper 本身沒有講者分辨,要另外裝能分辨講者的工具,例如 WhisperX。
整理待辦:負責人和期限最容易出錯
接著把逐字稿交給三個在 Ollama 上跑的開源模型:qwen3.5 9B、gemma4 12B、gpt-oss 20B,名字後面的數字是模型大小,越大越吃電腦記憶體。每個模型各試三種逐字稿:
- 原稿+講者名:完全正確,每句都標了誰說的。
- 原稿不標講者:完全正確,但看不出哪句是誰說的。
- Whisper 逐字稿:medium 轉出來的版本,有轉錯,也沒標講者。
給模型的指示都一樣:只寫逐字稿裡有的內容,負責人或期限沒講清楚就寫「未指定」。標準答案是雅婷散會前口頭整理的 7 項待辦;志明說的 12 月 10 日那件事不在這 7 項裡,下面另外看它有沒有被寫進去。
| 模型 | 原稿+講者名 | 原稿不標講者 | Whisper 逐字稿 | 每次耗時 |
|---|---|---|---|---|
| qwen3.5 9B | 漏掉「回覆客戶」那一項 | 7 項都在,2 項寫未指定 | 漏 1 項;雅婷要寄的試吃品派給了佩君 | 14–16 秒 |
| gemma4 12B | 7 項全對 | 7 項都在,2 項負責人只寫「發言人」 | 7 項都在,名字沿用轉錯的寫法 | 106–147 秒 |
| gpt-oss 20B | 「週三」「下週一」換成錯的日期 | 期限全加上 2024 年,週三、下週一也換錯 | 2 項派錯人 | 16–19 秒 |
gpt-oss 有一個控制回答隨機程度的設定(temperature)。我們一開始調到最穩定的 0,它反而有兩次卡住,其中一次把「雅婷|送試吃品 20 盒」這一行重複了三百多次;改回 OpenAI 建議的 1.0 才正常。
先講做得好的地方。9 份紀錄沒有一份把改口前的 1,200 盒寫進去,也沒有一份把「IG 抽獎,年後再說」列成待辦。模型對「講錯了,是 1,500」這種更正處理得不錯。
問題出在三個地方:
- 只講過一次的事,9 份都漏掉:志明說最晚 12 月 10 日要生產完,因為 12 月 15、16 日工廠歲修。這句只在會議中間講過一次,雅婷最後的整理沒有再提,9 份就全都沒寫。模型抓得到的,主要是被清楚交辦、最好還被複述過的事。
- 負責人派錯:原稿標了講者,gemma4 七項全對;拿掉講者後,「這個我來寄」的「我」就只能寫成未指定或發言人。這還算老實。用 Whisper 逐字稿時,qwen3.5 和 gpt-oss 都把這件事派給了佩君。我猜是因為接下來幾句是佩君問 SGS 報告、雅婷請她去找,名字剛好就在附近。
- 日期被換算錯:逐字稿裡沒有會議日期,只有「週三」「下週一」和「禮拜五,十月十六號」。gpt-oss 自己把它們換成具體日期,週三變成 10 月 12 日、下週一變成 10 月 9 日,不標講者的那一份還全部加上 2024 年。這就是 AI 幻覺出現在會議紀錄裡的樣子:格式整齊、看起來很合理,只是不對。
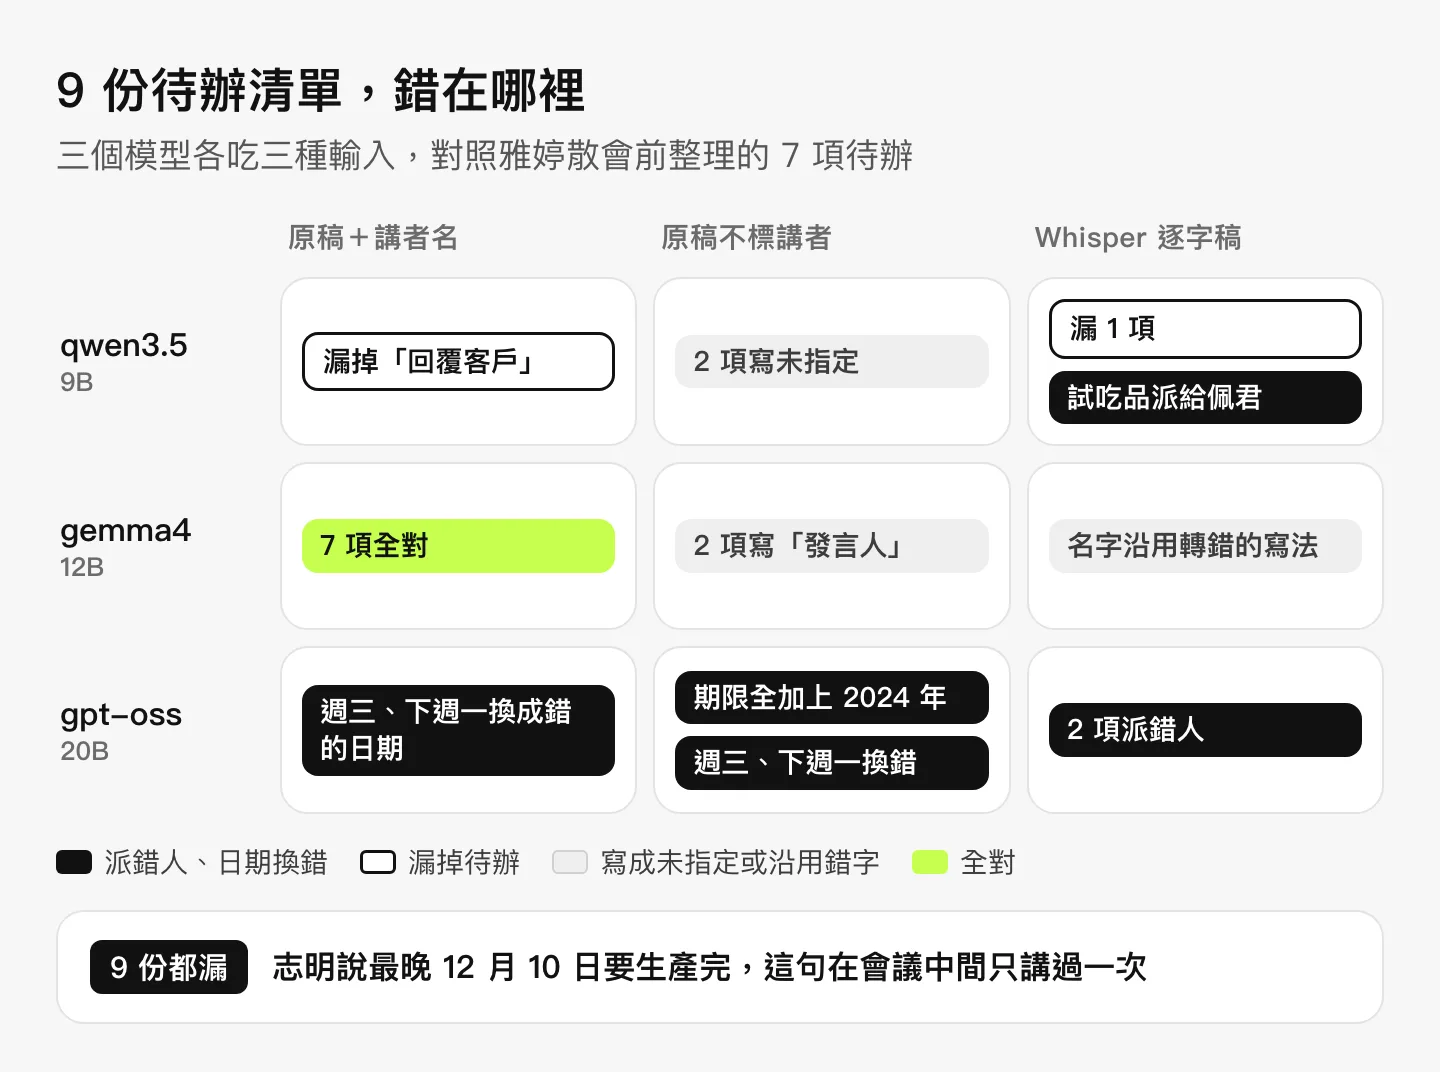 派錯人都出現在 Whisper 逐字稿那一欄,日期換錯都出現在 gpt-oss 那一列;而只講過一次的那件事,9 份都沒寫進去。
所以開頭那個問題,我的答案是不能直接寄。AI 整理的待辦可以當草稿,寄出前要有人對過負責人和期限。一場會議、一台電腦、一組設定,只能看出錯誤的方向;換成你們的會議和工具,表現會不一樣,導入前用自己的錄音測一輪最準。
錯在哪一關,就在哪一關擋
照測試裡錯的地方,一關一關補:
- 開會時:交辦點名到人、講出日期,散會前由主持人花一分鐘把待辦複述一次。測試裡只講一次的承諾 9 份全漏,最後被複述的七項大多抓到了。在這次測試裡,一件事有沒有被複述,比用哪個模型更能決定它會不會被漏掉。
- 錄音時:線上會議用會議系統內建的錄音,或用能同時錄到電腦播出的聲音(也就是其他人說話)的桌面 App;實體會議把手機放在桌子中間。Notion 的說明就提到,瀏覽器版只錄得到自己的麥克風。
- 轉逐字稿時:工具有講者分辨就打開;準備一份名詞表,放客戶名、產品名、同事名字和常用縮寫。要繁體中文輸出,提示就用繁體寫。
- 整理時:提示裡寫明「沒講清楚的寫未指定」「期限照原話寫,不要換算」。相對日期留給人換算,模型不知道會議是哪一天開的。
- 寄出前:花十分鐘,對照錄音或逐字稿檢查下面五項。
| 核對項目 | 為什麼要看 | 怎麼查 |
|---|---|---|
| 每項待辦的負責人 | 沒有講者時最常派錯 | 找回交辦那句話,看是誰說「我來」 |
| 期限 | 模型會把「下週一」換成錯的日期 | 只留原話,或由人換成日期 |
| 數字 | 改口前後的數字都會出現在逐字稿 | 看最後定案的那一次 |
| 客戶名、產品名 | 同音字最常出錯 | 和名詞表對一遍 |
| 還沒決定的事 | 可能被寫成決議 | 看原話是「先這樣做」還是「等某件事再說」 |
錄音之前,先講好告知和存放
先講告知。OpenAI 和 Notion 的說明都要求錄音前取得與會者同意;Notion 還能設定在開始轉錄時自動播一段告知語音。有客戶或廠商參加的會議更要先說,開場一句「這場會議會錄音,用 AI 整理紀錄」就夠。
帳號要用公司的。ChatGPT 的錄音轉完就刪,但逐字稿和摘要會留在對話紀錄裡;用個人的 Plus 或 Pro 方案、又開著「改善模型」設定時,這些內容可能被拿去訓練,Business、Enterprise、Edu 工作區則預設排除。員工用個人帳號錄公司會議,紀錄就不在公司的管理範圍內,規範怎麼訂可以看 Shadow AI 與企業 AI 使用規範。
最後是存放與權限:紀錄放在哪、誰看得到、留多久。
- Teams:會議回顧只有組織內受邀的人看得到。
- Google Meet:筆記放在召集人的雲端硬碟,由召集人決定分享給誰。
- ChatGPT:紀錄跟著工作區的保存設定,刪除對話後 30 天內從系統移除。
- 本機:錄音和逐字稿都只存在這台電腦裡,但備份、誰能看、什麼時候刪,也都要自己管。本機跑模型的安裝與設定,可以看 Ollama 教學。
從一場例行會議開始
我建議先挑一場每週固定、沒有外部人員的內部會議試三週。這三週照舊有人手寫紀錄,同時讓 AI 也出一份,會後兩份對照,記下 AI 錯在哪一類:名字、負責人、日期,還是漏掉整件事。三週後再決定要不要推到其他會議,以及核對工作交給誰。
如果下一步是讓待辦自動進到專案管理或 CRM,那已經是流程自動化的範圍,先看哪些流程適合交給 AI agent,評估這一段值不值得接。要把散會後的待辦自動開成工單、指派給負責人,我們的企業 AI 營運方案會把這段接進你們的專案管理或 CRM,負責人或期限不明的項目先暫停,交給專人確認再送出。
常見問題
不想付費,可以自己做 AI 會議記錄嗎?
可以。用 Whisper 這類開源語音模型在自己電腦上轉逐字稿,再交給 Ollama 上的開源模型整理,不用授權費,錄音和逐字稿也都留在自己的電腦裡。代價是要自己安裝、自己核對:我們的實測裡,medium 模型轉 4 分半的錄音要兩分多鐘,較小或較快的模型還會夾簡體字,也都分不出講者。
Google Meet 可以做中文的 AI 會議紀錄嗎?
依 Google 目前的說明,Meet 的「幫我做筆記」和逐字稿都只支援英、法、德、義、日、韓、葡、西 8 種語言,全中文的會議用不上。可以另外錄音,再用支援中文的工具轉逐字稿和整理。
AI 會議記錄分得出誰說了什麼嗎?
看工具。Teams 的逐字稿會標講者,ChatGPT 的錄音模式、雅婷逐字稿和 Plaud 也能分辨多位講者;Notion 的講者標記目前只支援英文;本機的 Whisper 預設沒有這個功能。分不出講者時,「我來處理」這類交辦最容易派錯人,整理出的待辦要人工補上負責人。
會議錄音要先取得與會者同意嗎?
要。OpenAI 和 Notion 的說明都要求使用者錄音前取得同意,OpenAI 也提醒要先確認當地法規。實務上在會議開頭講一句、或用工具的告知語音,讓每個人知道會錄音和用 AI 整理;有外部客戶的會議,最好事先在邀請裡寫明。
參考來源
以下依各家官方說明整理,支援語言、方案門檻與紀錄保存設定以官方頁面當下為準。
- Microsoft Support:Meeting recap in Microsoft Teams
- Google Meet 說明:Take notes for me in Google Meet
- Google Meet 說明:Use transcripts with Google Meet
- OpenAI Help Center:ChatGPT Record
- Notion Help:AI Meeting Notes
- Notion Help:Notion AI 常見問題
- 雅婷逐字稿:產品介紹
- Plaud Support:How many languages does Plaud support for transcription?
- Plaud:產品與方案
- GitHub:openai/whisper
- GitHub:SYSTRAN/faster-whisper
- GitHub:openai/gpt-oss